

Quản trị rủi ro khi nâng cấp Kubernetes 1.37 trên VPS: Xử lý Kube-DNS, cgroup v1 và legacy service
Cảnh báo kubelet crashloop, pod kẹt ở trạng thái Pending, hay các microservices bỗng dưng mất kết nối không thể resolve API nội bộ, đây là những kịch bản thực tế đang diễn ra trên nhiều diễn đàn DevOps khi bản cập nhật Kubernetes 1.37 (Garhwal) được triển khai. Nếu bạn đang vận hành cluster trên các nền tảng cloud quản lý tự động (như GKE, EKS), nhà cung cấp đã âm thầm xử lý những thay đổi kiến trúc ngầm.
Tuy nhiên, với các Sysadmin tự tay bảo trì hạ tầng hoặc đang tiến hành cài đặt Kubernetes nhẹ (K3s) trên VPS Linux, việc vội vàng chạy lệnh nâng cấp Kubernetes 1.37 trên VPS mà không rà soát lại nợ kỹ thuật (technical debt) sẽ dễ dàng làm gián đoạn toàn bộ node. Đâu là những điểm nghẽn thực sự của bản 1.37 và làm thế nào để dọn dẹp các VPS dùng image Linux cũ mà vẫn giữ vững uptime cho ứng dụng?
Sự thật về Kubernetes 1.37: Đâu mới là bom nổ chậm?
Kỹ năng sinh tồn của mọi kỹ sư vận hành là đọc kỹ Release Notes để phân biệt rõ giữa tính năng bị phản đối (deprecated) và tính năng bị vô hiệu hóa (removed). Bản cập nhật này có những thay đổi cốt lõi buộc chúng ta phải thay đổi tư duy quản trị.
Đính chính timeline: Kube-DNS và cgroup v1
Hai thành phần thường xuyên bị nhầm lẫn về mức độ khẩn cấp trong đợt cập nhật này cần được làm rõ:
- Cgroup v1 (Rủi ro tức thì): Kubernetes đã đưa cgroup v1 vào trạng thái phản đối từ phiên bản v1.35. Bước sang bản 1.37, cấu hình
FailCgroupV1của kubelet chính thức được thiết lập mặc định làtrue. Kubelet được lập trình để tự động kiểm tra phân vùng quản lý tài nguyên của hệ điều hành. Nếu phát hiện node đang chạy cgroup v1, nó sẽ chặn tiến trình khởi động. Việc phớt lờ rủi ro này sẽ biến một chu kỳ update bình thường thành một sự cố ngừng hoạt động node diện rộng. - Kube-DNS (Chính thức bước vào giai đoạn Deprecated): Mặc dù CoreDNS đã đảm nhận vai trò DNS mặc định từ v1.13, bản 1.37 mới là cột mốc chính thức đưa
kube-dnsaddon (bao gồm bộ 3 container legacy:kubedns,dnsmasq,sidecar) vào danh sách phản đối.- Điều quan trọng Sysadmin cần nắm rõ: Kubernetes chỉ deprecated bộ cài addon cũ, còn đối tượng Service mang tên
kube-dnstrong namespacekube-systemvẫn được giữ lại để làm đầu mối định tuyến traffic đến các Pod CoreDNS bên dưới. Dù addon cũ chưa gây gián đoạn hệ thống tức thì, kỳ nâng cấp lần này là thời điểm phù hợp để bạn quy hoạch lại hạ tầng và dọn dẹp các thành phần không còn được cộng đồng hỗ trợ, đảm bảo tương thích ngược cho các workload cũ.
- Điều quan trọng Sysadmin cần nắm rõ: Kubernetes chỉ deprecated bộ cài addon cũ, còn đối tượng Service mang tên
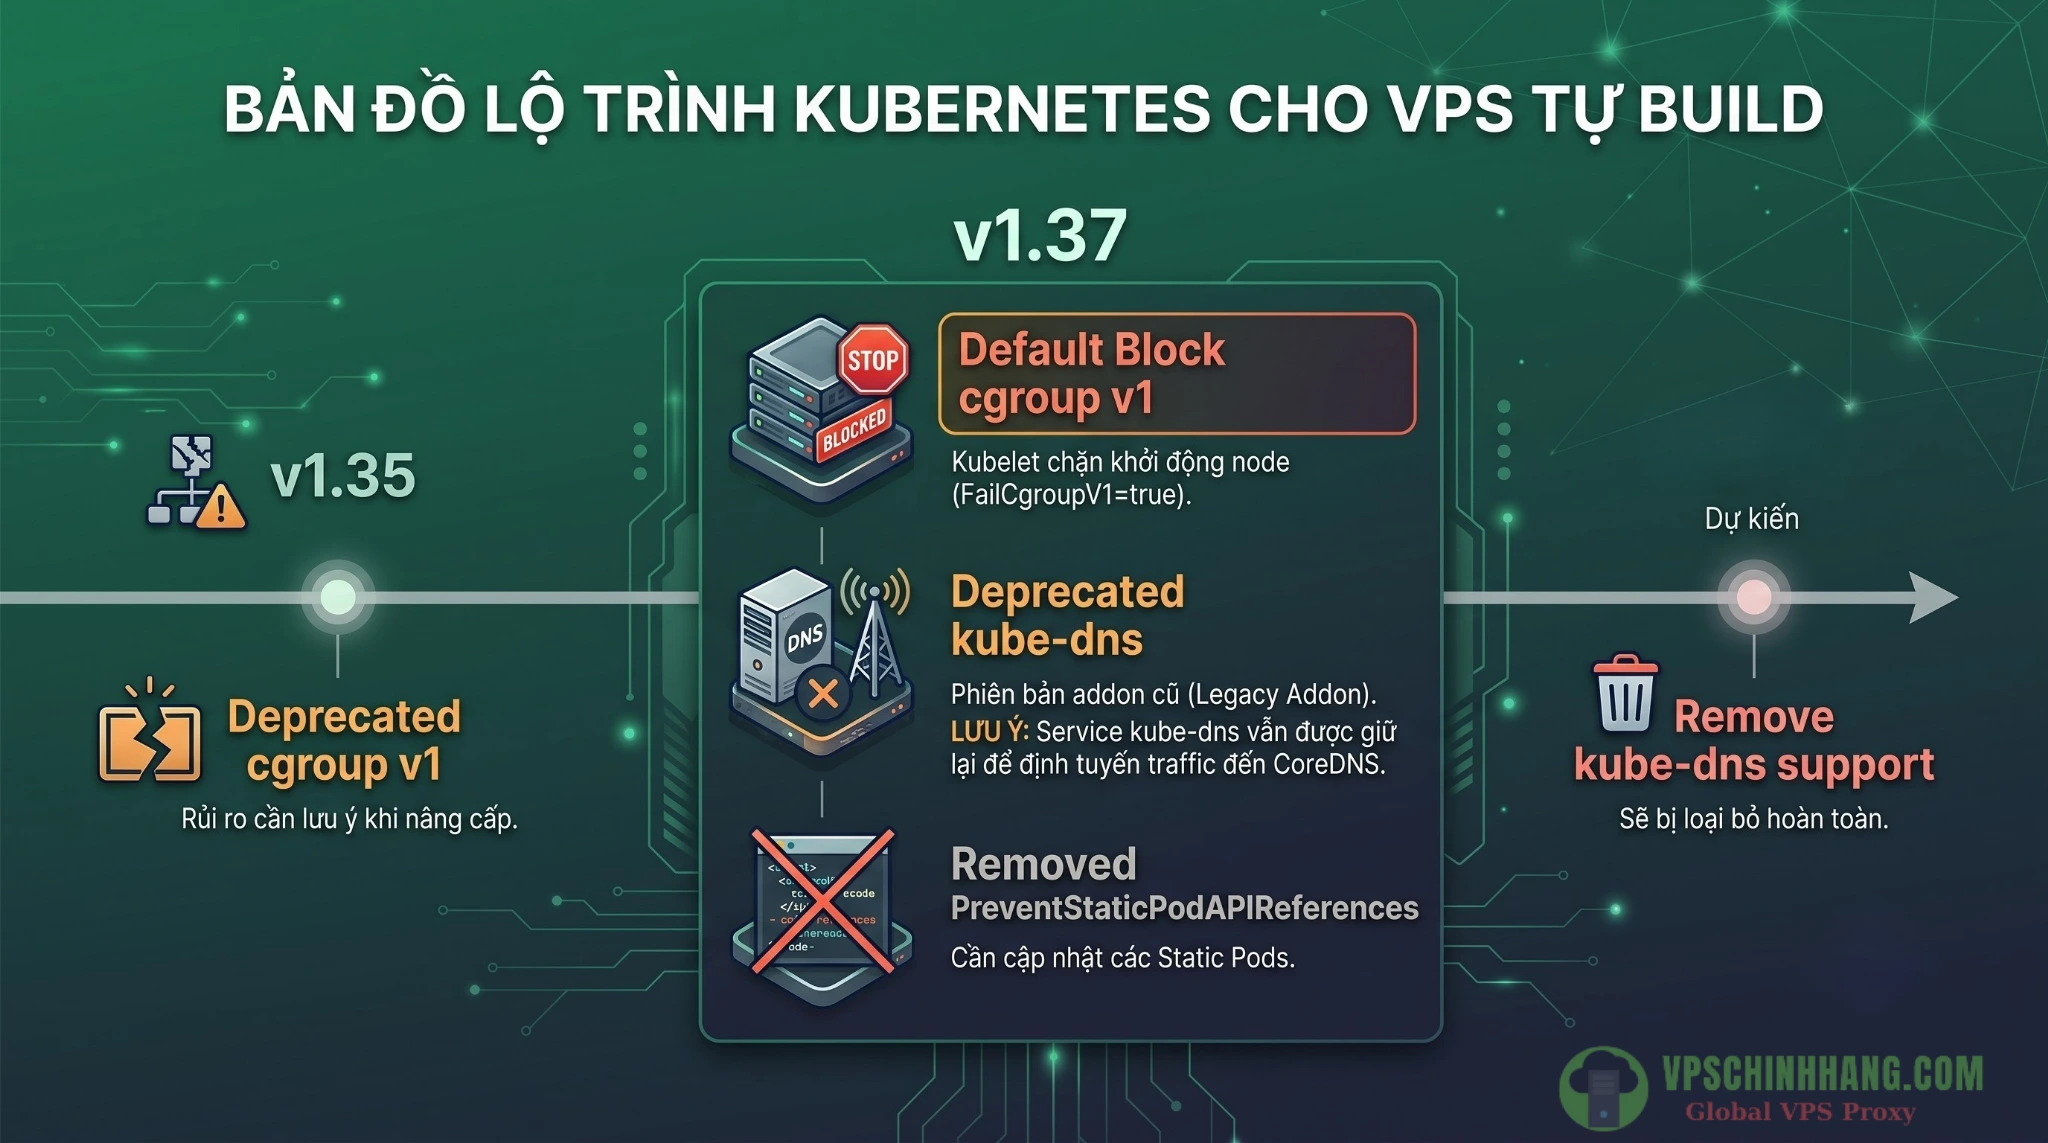
Lộ trình chuyển dịch và phản đối các thành phần kỹ thuật cũ trên Kubernetes từ bản v1.35 đến v1.37.
Breaking change: Static Pod bị chặn tham chiếu API
Một thay đổi kiến trúc khắt khe khác của bản 1.37 là cổng tính năng PreventStaticPodAPIReferences đã bị gỡ bỏ.
Các Static Pod (thường dùng để chạy Control Plane như etcd, kube-apiserver lưu trong /etc/kubernetes/manifests) không còn khả năng gọi đến các tài nguyên API động như Secret hay ConfigMap qua cấu hình secretRef hoặc configMapRef.
Lý do kỹ thuật xuất phát từ việc ngăn chặn vòng lặp phụ thuộc (dependency loop): nếu API Server chưa khởi chạy, kubelet không thể phân giải Secret để dựng Static Pod, dẫn đến trạng thái deadlock. Nếu các script bootstrap node của bạn đang nạp chứng chỉ TLS theo phương pháp cũ, cluster sẽ bị lỗi khi update. Thay vào đó, Sysadmin phải chuyển sang sử dụng tệp tin cục bộ kết hợp với cấu hình volume dạng hostPath.
Audit hệ thống trước khi nâng cấp Kubernetes 1.37 trên VPS
Để quá trình nâng cấp Kubernetes 1.37 trên VPS diễn ra mượt mà, kỹ sư vận hành cần rà soát kỹ lưỡng trạng thái các node và DNS add-on đang chạy.
Rà soát DNS add-on: Phân biệt Pod CoreDNS và Service kube-dns
Rất nhiều kỹ sư nhầm lẫn giữa Provider thực tế chạy bên dưới và đối tượng Service bên trên. Lệnh kubectl get svc -n kube-system kube-dns sẽ luôn trả về một Service mang tên kube-dns nhằm mục đích đảm bảo tương thích ngược. Để kiểm tra đúng Provider đang hoạt động, bạn cần đếm số lượng container bên trong Pod:
kubectl get pods -n kube-system -l k8s-app=kube-dns -o jsonpath='{.items[*].spec.containers[*].name}'- CoreDNS: Chỉ trả về 1 container mang tên
coredns. - Kube-DNS: Trả về 3 container chạy song song (
kubedns,dnsmasq,sidecar).
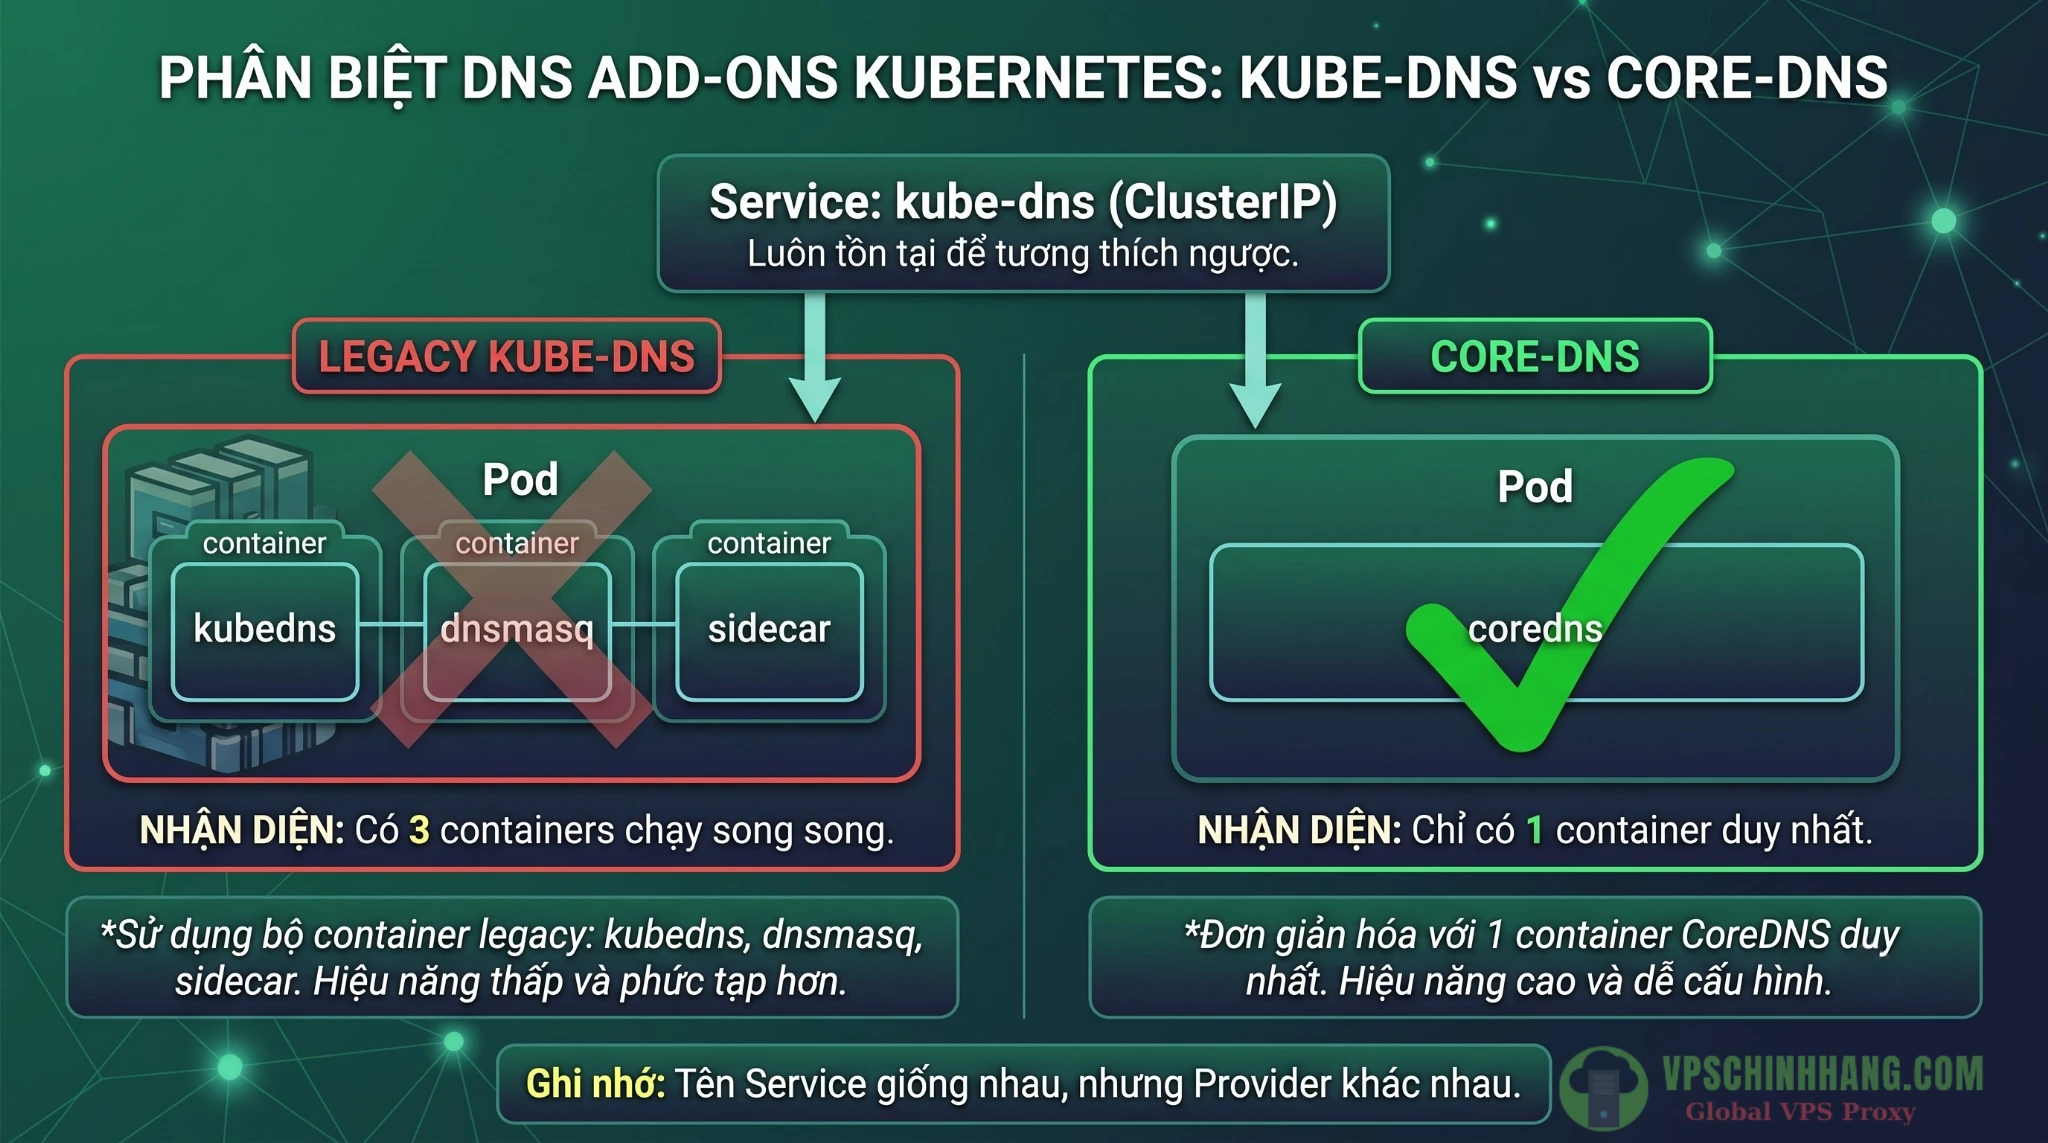
Sự khác biệt về kiến trúc container giữa Kube-DNS (trái) và CoreDNS (phải) dưới cùng một đối tượng Service Name.
Kiểm tra cgroup v1/v2 trên từng node Linux
Bạn cần SSH vào toàn bộ node (bao gồm master và worker) để kiểm tra cấu trúc phân cấp tài nguyên đang được kernel sử dụng:
stat -fc %T /sys/fs/cgroup/cgroup2fs: Hệ điều hành đã dùng cgroup v2. Node đã sẵn sàng để nâng cấp.tmpfs: Node đang chạy cgroup v1. Bạn bắt buộc phải nâng cấp OS hoặc can thiệp cấu hình bootloader (GRUB) trước khi chạy lệnh nâng cấp cluster.
Tự động hóa chuyển đổi DNS và cạm bẫy tương thích
Nếu cụm cluster vẫn đang dùng kube-dns cũ, bạn không cần tốn thời gian trích xuất cấu hình JSON (stubDomains, upstreamNameservers) và dịch thủ công sang định dạng Corefile. Việc cấu hình tay dễ dẫn đến sai sót trong định tuyến mạng (network routing), lúc này bạn có thể cân nhắc cấu hình Cilium CNI cho VPS Kubernetes để quản lý luồng traffic cấp độ kernel.
Sức mạnh tự động hóa của Kubeadm
Với các cụm được quản lý bằng kubeadm, công cụ này đã tích hợp sẵn luồng chuyển đổi DNS an toàn. Khi bạn chạy chu trình nâng cấp tiêu chuẩn, trước tiên hãy kiểm tra kế hoạch nâng cấp:
kubeadm upgrade planSau đó áp dụng phiên bản nâng cấp:
kubeadm upgrade apply v1.37.xkubeadm sẽ tự động phân tích cấu hình kube-dns hiện tại, sinh ra file Corefile tương ứng và thực hiện quá trình rollout sang CoreDNS một cách trơn tru.
Cạm bẫy cần né: Giữ nguyên tên Service kube-dns
Sau khi CoreDNS hoạt động ổn định, một sai lầm trầm trọng là xóa Service kube-dns để tạo Service mới mang tên coredns.
Service kube-dns đóng vai trò trừu tượng hóa nhà cung cấp. Kubelet sẽ tự động nạp ClusterIP của Service này vào tệp /etc/resolv.conf của mọi Pod thông qua cờ --cluster-dns. Nếu đổi tên, toàn bộ các ứng dụng kế thừa (legacy apps) đang hard-code gọi đến đích danh kube-dns sẽ gặp lỗi NXDOMAIN (không tìm thấy tên miền). CoreDNS mặc định vẫn sử dụng label k8s-app: kube-dns để traffic tự động chảy về đúng đích mà không gây gián đoạn.
Bạn có thể tham khảo bài so sánh iptables, nftables và tường lửa để hiểu cơ chế chặn/mở gói tin.
Xử lý bài toán cgroup v1 trên các VPS Linux đời cũ
Với các node trả về kết quả tmpfs, Sysadmin phải xử lý tận gốc vấn đề để vượt qua rào cản FailCgroupV1=true của kubelet.
Lựa chọn nâng cấp OS hay ép cấu hình qua GRUB?
- Nâng cấp hệ điều hành (Đề xuất): Thay thế các VPS chạy Ubuntu 20.04/Debian 10 bằng các phiên bản đời mới như Ubuntu 22.04+ hoặc Rocky Linux 9. Đây là phương án mang tính bền vững vì các kernel mới không chỉ hỗ trợ cgroup v2 từ cấp độ lõi mà còn giúp bảo mật VPS Linux với các lớp phòng thủ thiết yếu.
- Ép cấu hình qua GRUB: Nếu việc thay đổi OS gặp khó khăn do các service đi kèm, bạn có thể buộc kernel nhận diện cgroup v2. Mở file
/etc/default/grub, tìm chỉ thịGRUB_CMDLINE_LINUXvà bổ sung tham số:GRUB_CMDLINE_LINUX="systemd.unified_cgroup_hierarchy=1 cgroup_no_v1=all"Cập nhật lại bootloader bằng lệnh
sudo update-grub(Debian/Ubuntu) hoặcsudo grub2-mkconfig -o /boot/grub2/grub.cfg(RHEL/CentOS) và reboot server.
Kubelet tự động nhận diện cgroup driver (từ v1.28)
Để cgroup v2 hoạt động trơn tru, Container Runtime (ở đây là containerd) phải sử dụng systemd làm cgroup driver thay vì cgroupfs. Bạn mở file /etc/containerd/config.toml và bật cờ cấu hình:
[plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc.options]
  SystemdCgroup = true
Sau đó khởi chạy lại dịch vụ bằng lệnh sau:
sudo systemctl restart containerdĐiểm cải tiến của các phiên bản Kubernetes đời mới là từ bản v1.28, kubelet đã hỗ trợ tính năng tự động nhận diện cgroup driver từ CRI runtime nhờ cờ KubeletCgroupDriverFromCRI. Bạn không cần mở file KubeletConfiguration để chỉnh sửa đồng bộ bằng tay như trước. Kubelet sẽ tự động giao tiếp với containerd và nhận cấu hình systemd một cách thông minh, giảm thiểu rủi ro sai sót cấu hình.
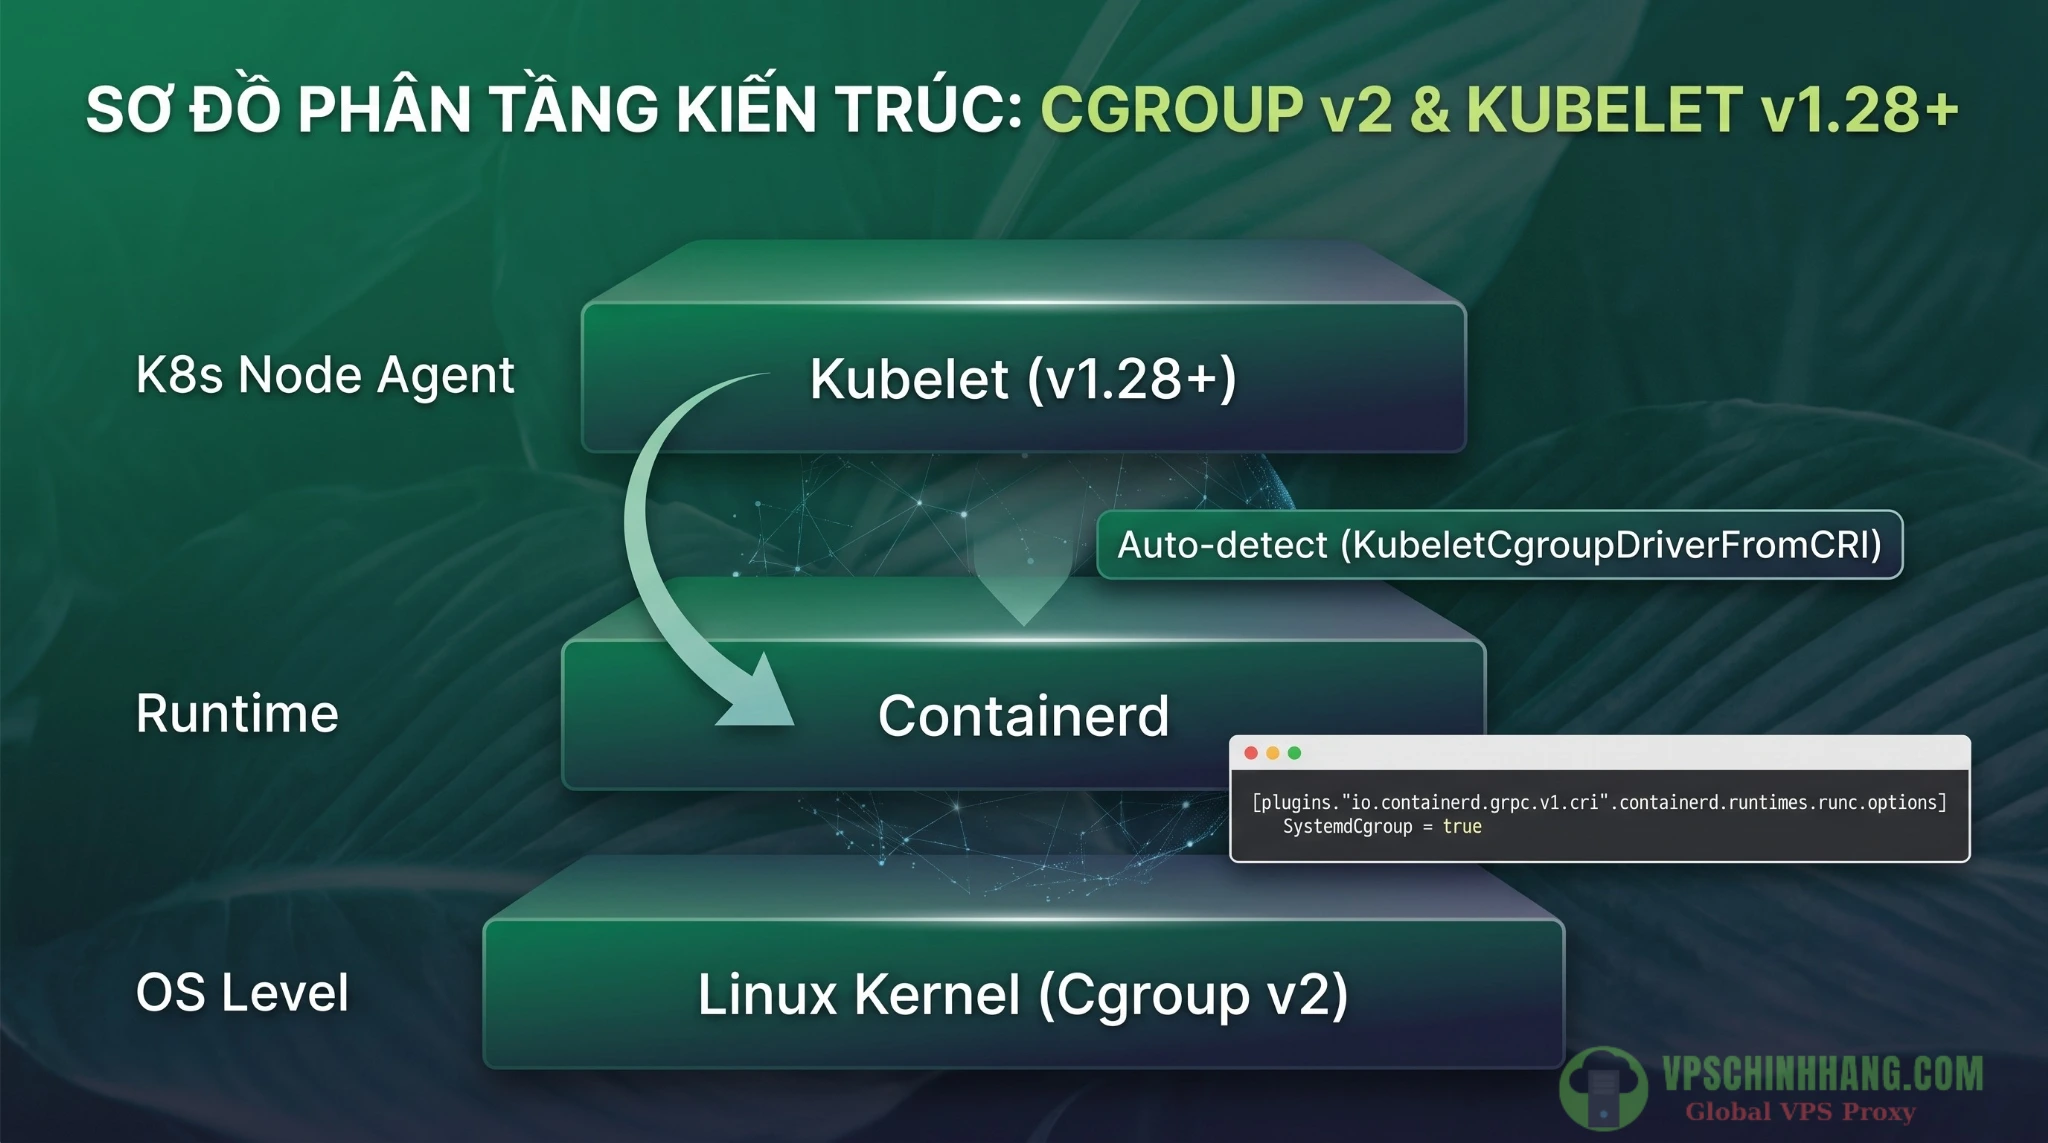
Cơ chế Kubelet tự động nhận diện cấu hình cgroup driver từ CRI runtime (containerd) không cần thiết lập thủ công.
Quy trình rolling upgrade không gián đoạn Service
Khi rào cản DNS và cgroup đã được dọn dẹp, bước tiếp theo là tiến hành nâng cấp tuần tự (rolling upgrade) để bảo vệ uptime cho các ứng dụng.
Cordon, drain và nâng cấp tuần tự
Không thực hiện update đồng loạt trên toàn bộ node. Áp dụng quy trình sau cho từng worker node một cách cẩn trọng:
1. Cô lập và trục xuất (Cordon & Drain):
Đầu tiên, đánh dấu node là không thể lập lịch:
kubectl cordon worker-node-1Sau đó, di dời an toàn các pod khỏi node:
kubectl drain worker-node-1 --ignore-daemonsets --delete-emptydir-dataLệnh này báo cho control plane ngừng nạp pod mới vào node, đồng thời di dời các pod hiện tại sang các node khỏe mạnh khác.
2. Nâng cấp các gói hệ thống:
Sử dụng apt hoặc yum để nâng cấp gói kubeadm, chạy lệnh sudo kubeadm upgrade node. Tiếp theo, cập nhật gói kubelet và kubectl lên phiên bản tương ứng.
3. Khởi động lại & mở khóa (Uncordon):
Tải lại cấu hình systemd:
sudo systemctl daemon-reloadKhởi động lại dịch vụ kubelet:
sudo systemctl restart kubeletCuối cùng, mở khóa node để tiếp tục nhận workload mới:
kubectl uncordon worker-node-1Theo dõi log bằng journalctl -u kubelet -f để đảm bảo service chạy xanh (active) trước khi chuyển sang node tiếp theo.
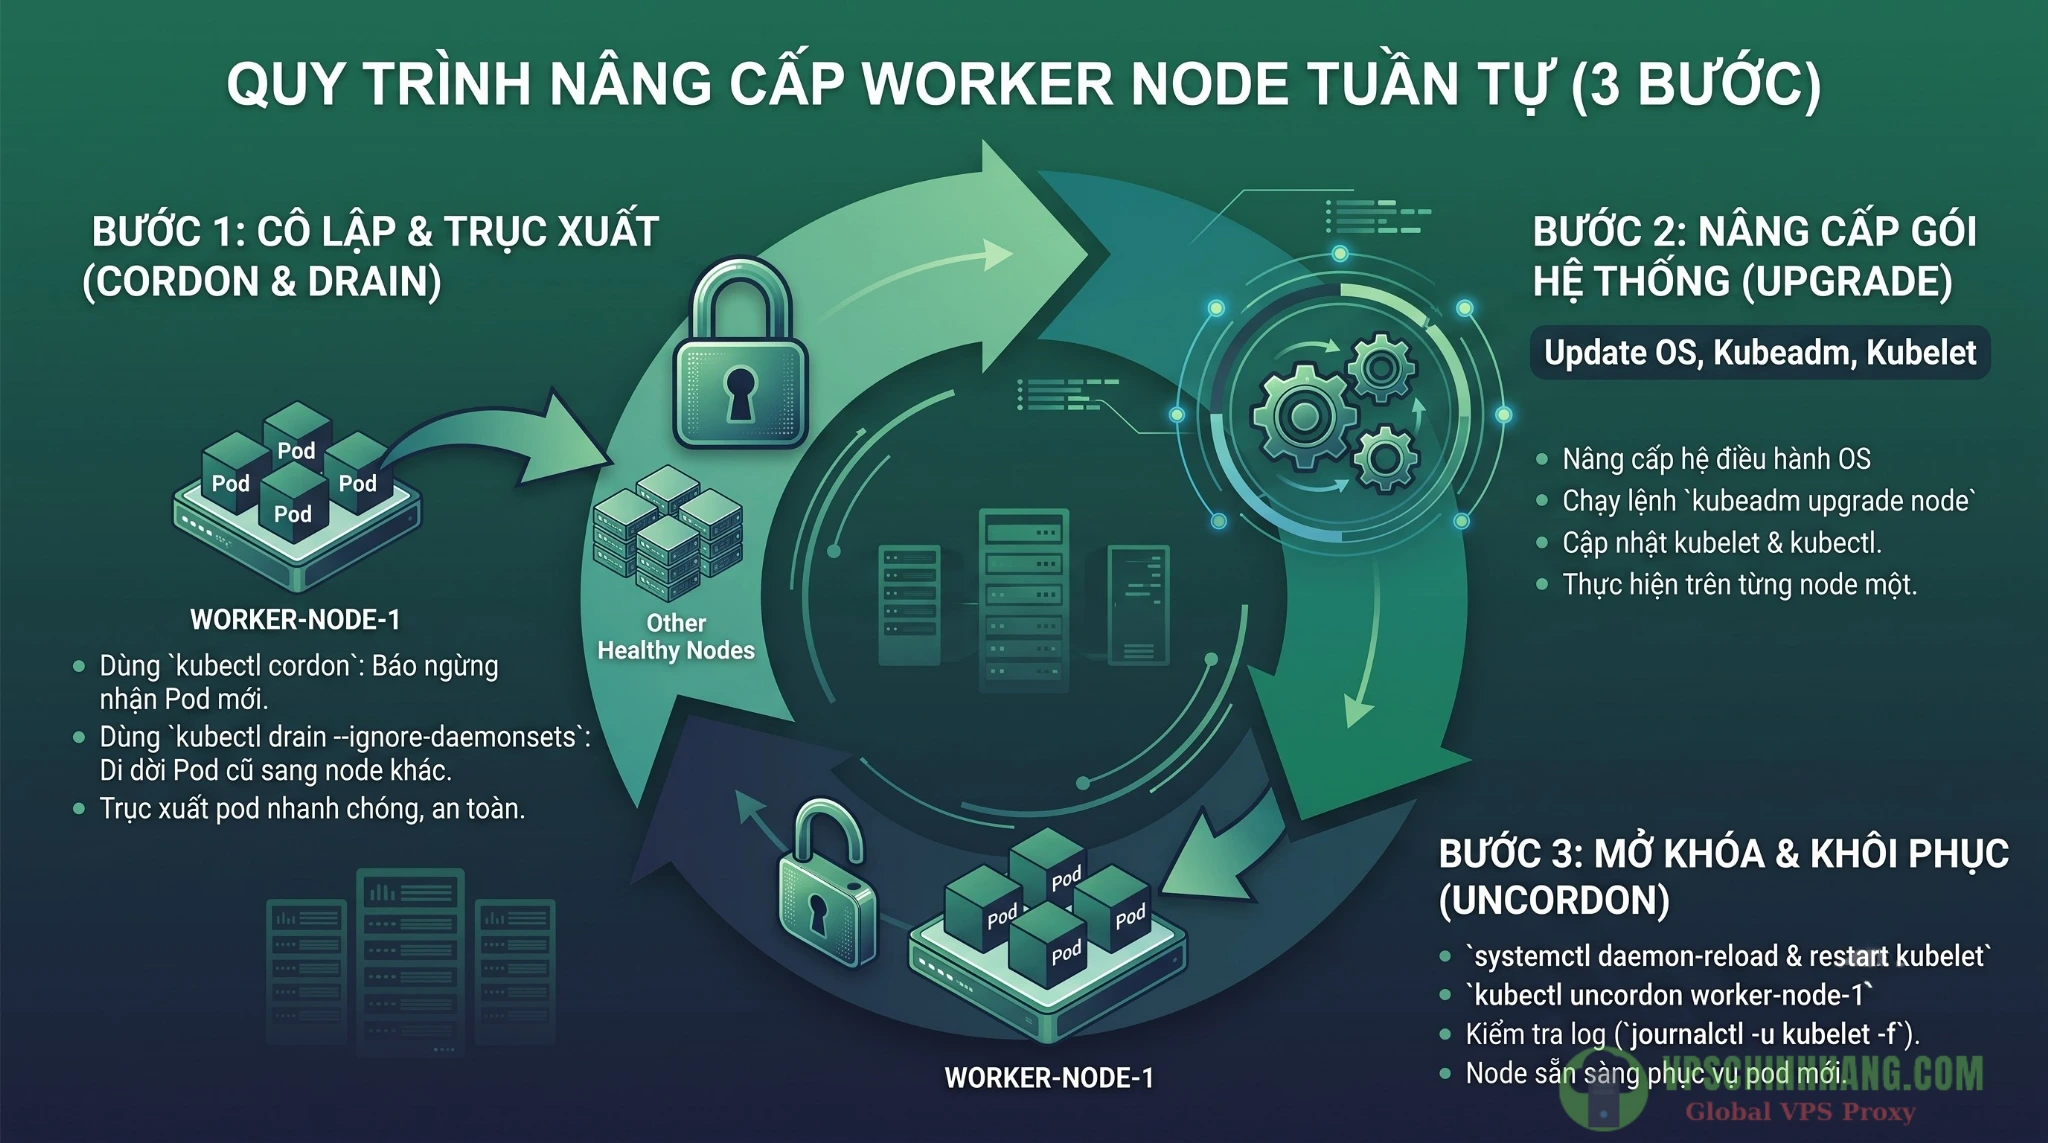
Vòng lặp 3 bước nâng cấp cuốn chiếu (Rolling Upgrade) giúp duy trì uptime cho các microservices trong suốt quá trình bảo trì.
Kiểm tra metrics ứng dụng trên cgroup v2
Sau khi chuyển sang hạ tầng cgroup v2 và thiết lập hệ thống giám sát Kubernetes trên K3s bằng Prometheus & Grafana, các ứng dụng viết bằng Java (JVM) hoặc Go có xu hướng báo cáo mức sử dụng RAM cao hơn trên các dashboard như Grafana/Prometheus. Đừng vội kết luận đây là lỗi rò rỉ bộ nhớ (memory leak).
Nguyên nhân xuất phát từ sự khác biệt trong cơ chế tính toán tài nguyên của hệ điều hành. Dưới đây là bảng phân tích kỹ thuật giúp Sysadmin nắm bắt sự thay đổi:
| Tiêu chí | Cơ chế cgroup v1 | Cơ chế cgroup v2 |
| Cấu trúc quản lý | Đa phân cấp (Multiple hierarchies) | Phân cấp hợp nhất (Unified hierarchy) |
| Tham số giới hạn RAM | memory.max_limit_in_bytes |
memory.max |
| Chỉ số áp lực tài nguyên | Không hỗ trợ | Hỗ trợ PSI (Pressure Stall Information) giám sát I/O, CPU, RAM |
| Hạch toán bộ nhớ đệm (Cache) | Rời rạc, tỷ lệ sai số cao | Hạch toán hợp nhất các thay đổi gián tiếp (page cache writebacks) |
Dựa vào bảng trên, có thể thấy cgroup v2 tính toán bộ nhớ đệm trang (page cache) và file tạm khắt khe, bao quát hơn v1. Sysadmin cần xây dựng Dashboard giám sát VPS Linux với Prometheus và Grafana và theo dõi sát sao hệ thống trong 24-48 giờ đầu để tinh chỉnh lại các ngưỡng cảnh báo (alert thresholds), tránh tình trạng hệ thống monitoring gửi cảnh báo rác (false positives).
Câu hỏi thường gặp (FAQ)
1. Kube-dns đã bị loại bỏ ở bản Kubernetes 1.37 chưa?
Không. Phiên bản 1.37 chỉ đưa kube-dns vào danh sách phản đối (deprecated). Các gói cài đặt này dự kiến sẽ ngừng hỗ trợ ở bản 1.40. Tuy nhiên, việc chuyển đổi sang CoreDNS ở thời điểm này là cần thiết để đảm bảo an toàn cho hạ tầng mạng.
2. Tại sao Kubelet báo lỗi crashloop/không khởi động sau khi gõ lệnh nâng cấp?
Khả năng cao VPS của bạn đang sử dụng cgroup v1. Bản 1.37 đặt cờ FailCgroupV1 mặc định là true, khiến kubelet từ chối chạy trên hạ tầng cũ. Bạn cần nâng cấp hệ điều hành hoặc can thiệp tham số GRUB để kích hoạt cgroup v2.
3. Tôi đang quản lý cụm bằng Kubeadm, có cần tự viết cấu hình Corefile thủ công không?
Không. Khi bạn thực hiện lệnh kubeadm upgrade apply, hệ thống sẽ tự động quét cấu hình DNS cũ và chuyển đổi mượt mà sang định dạng Corefile mới, giúp giảm thiểu rủi ro sai lệch định tuyến.
4. Lệnh nào kiểm tra nhanh VPS đã nhận cgroup v2 hay chưa?
Bạn truy cập SSH vào node và chạy lệnh stat -fc %T /sys/fs/cgroup/. Nếu kết quả trả về cgroup2fs, hệ điều hành đã sẵn sàng. Nếu trả về tmpfs, hệ thống vẫn đang kẹt ở cgroup v1.
5. Tại sao Control Plane (etcd, apiserver) ngừng hoạt động khi update lên 1.37?
Do cấu hình Static Pod của bạn đang tham chiếu đến Secret hoặc ConfigMap. Phiên bản 1.37 đã gỡ bỏ cổng tính năng này. Khắc phục bằng cách chuyển cấu hình chứng chỉ sang tệp tin cục bộ (Local Files) và mount thông qua hostPath.
Kết luận
Việc cập nhật kiến trúc hạ tầng đòi hỏi sự tỉ mỉ trong khâu rà soát và sự quyết đoán khi loại bỏ các công nghệ lỗi thời. Nắm vững tính năng tự động hóa của kubeadm, hiểu sâu cơ chế nhận diện tự động của kubelet với cgroup v2 sẽ giúp các kỹ sư chủ động kiểm soát quá trình bảo trì, tối ưu hóa hiệu năng ứng dụng mà không gặp phải các sự cố gián đoạn ngoài ý muốn.
Tài liệu tham khảo