

Hướng dẫn cài đặt DuckDB trên VPS Linux: Tối ưu truy vấn phân tích chi phí thấp (2026)
Mỗi cuối tháng, không ít Data Engineer và Developer phải đối mặt với hóa đơn Cloud Data Warehouse (như BigQuery, Snowflake, hay Redshift) tăng vọt. Chỉ vì một vài câu truy vấn BI không được cấu hình kỹ, bảng dữ liệu bị quét toàn bộ (full-scan), chi phí Compute-hour và Egress fee có thể dội lên hàng ngàn đô la. Trong khi đó, với các tập dữ liệu ở mức vừa và nhỏ (dưới 1TB), việc vận hành một hệ thống phân tán đồ sộ mang lại sự cồng kềnh không đáng có.
Đó là lý do kiến trúc In-process OLAP đang trở thành xu hướng. Sự kiện AWS mua lại DuckLabs (tháng 8/2026) từng khiến giới công nghệ đặt câu hỏi về vấn đề bản quyền. Tuy nhiên, dự án DuckDB vẫn được quản lý độc lập bởi DuckDB Foundation và cam kết duy trì mã nguồn mở (MIT License). Điều này có nghĩa bạn hoàn toàn có thể tự build một cỗ máy phân tích dữ liệu tốc độ cao trên một máy chủ ảo với chi phí cố định hàng tháng.
Vậy làm thế nào để cài đặt DuckDB trên VPS và cấu hình hệ thống vượt qua giới hạn phần cứng mà không bị sập (OOM)? Kiến trúc xử lý tràn đĩa (Spill-to-disk) hoạt động ra sao? Cùng phân tích kỹ thuật qua kịch bản thực chiến dưới đây.
DuckDB + VPS: Lựa chọn thay thế Data Warehouse cho dataset dưới 1TB
Bản chất In-process OLAP: Vượt qua rào cản của cơ sở dữ liệu truyền thống
Khi vận hành PostgreSQL hay MySQL trên VPS, bạn đang chạy một tiến trình máy chủ độc lập (daemon) hoạt động 24/7. Hệ thống này liên tục tiêu tốn RAM, duy trì các kết nối mở và xử lý dữ liệu theo từng dòng (Row-store), cấu trúc này ưu việt cho các giao dịch chèn/cập nhật nhỏ lẻ (OLTP). Nhưng khi bạn đẩy một câu lệnh GROUP BY phân tích hàng chục triệu dòng log vào Postgres, CPU sẽ dễ dàng bị nghẽn, kéo theo rủi ro làm chậm các web service khác trên cùng VPS.
DuckDB giải quyết bài toán này bằng kiến trúc In-process OLAP:
- Không có Server ngầm: DuckDB chạy nhúng trực tiếp vào tiến trình gọi lệnh (CLI, Python, Node.js). Khi không có truy vấn, mức tiêu thụ tài nguyên nhàn rỗi (idle) bằng 0.
- Lưu trữ dạng cột (Columnar) & Xử lý Vectơ (Vectorized Execution): DuckDB tổ chức dữ liệu theo cột và xử lý theo từng cụm vectơ vừa vặn với bộ đệm L1/L2 Cache của CPU. Thay vì quét từng dòng, CPU sử dụng tập lệnh SIMD (Single Instruction, Multiple Data) để tính toán song song hàng ngàn điểm dữ liệu trong một chu kỳ xung nhịp.
- Mã song song Morsel (Morsel-Driven Parallelism): Dữ liệu tự động được băm nhỏ thành các mảnh (morsels) và phân bổ đều cho mọi lõi CPU vật lý, đẩy tốc độ truy vấn lên mức cao mà không cần cấu hình phức tạp.
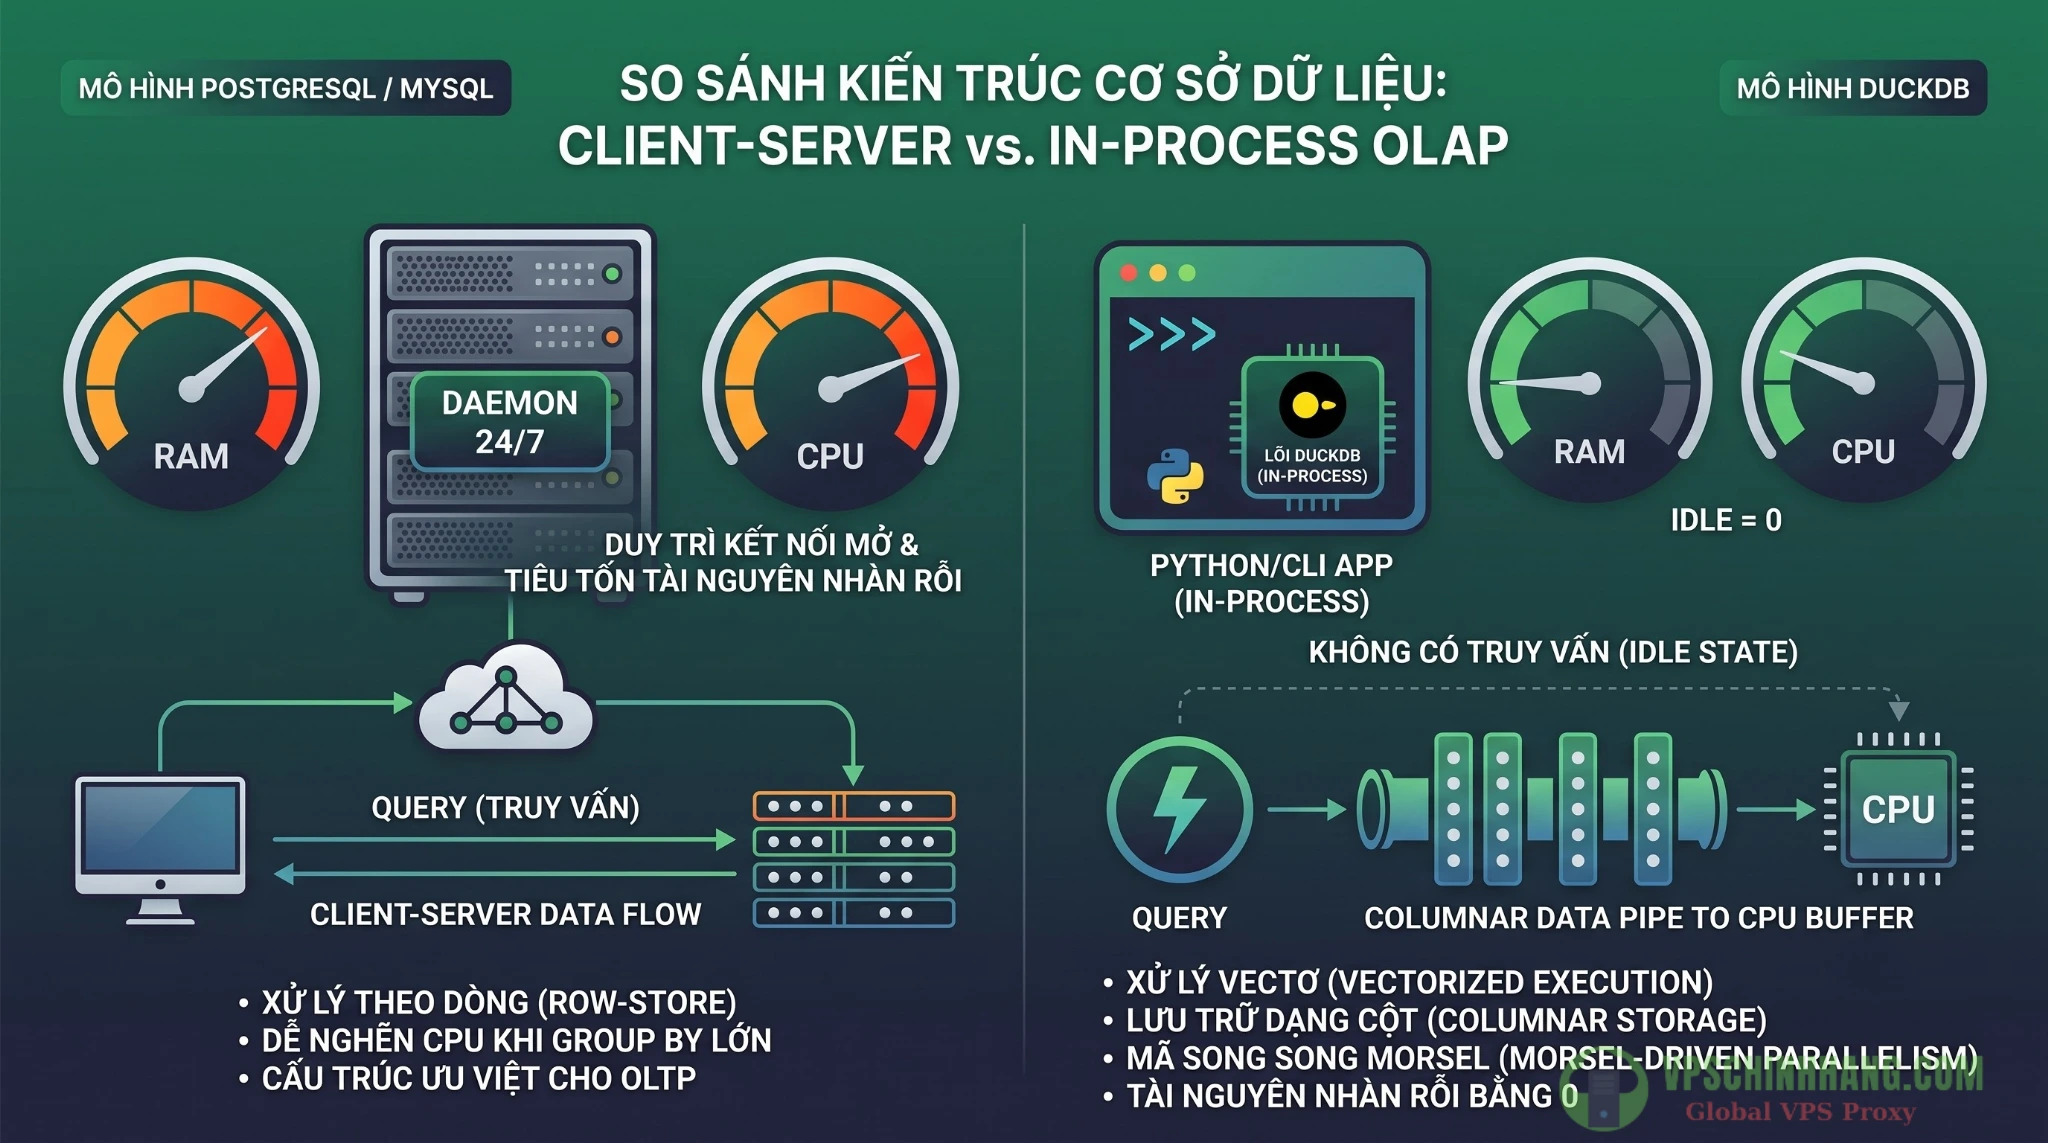
Sơ đồ minh họa sự khác biệt về tiêu thụ tài nguyên giữa kiến trúc In-process của DuckDB và mô hình Client/Server truyền thống.
Sự thật sau thương vụ AWS (tháng 8/2026): Không lo Vendor Lock-in
Việc AWS mua lại DuckLabs là một động thái thâu tóm nhân tài (acqui-hire) nhằm tích hợp công nghệ này sâu hơn vào S3. Tuy nhiên, mã nguồn, tài sản sở hữu trí tuệ và quyền quyết định vẫn nằm trong tay DuckDB Foundation (tổ chức phi lợi nhuận tại Amsterdam).
DuckDB được đảm bảo duy trì giấy phép MIT. Developer không phải đối mặt với các mô hình khóa giấy phép (như BSL) hay bị ép chuyển sang dịch vụ đám mây trả phí. Đội ngũ kỹ thuật hoàn toàn làm chủ Data Pipeline của mình trên hạ tầng VPS tự quản.
Bảng so sánh nhanh: Tự host VPS vs Cloud Data Warehouse
| Tiêu chí | Cloud Data Warehouse (BigQuery, Redshift) | Self-hosted DuckDB trên VPS |
| Chi phí Compute | Trả theo dung lượng quét (VD: ~$5/TB) hoặc theo số giờ kích hoạt cụm máy chủ. | Phí cố định theo gói VPS hàng tháng. Không phát sinh chi phí tính toán theo từng câu lệnh SQL. |
| Băng thông (Egress Fee) | Tính phí khi kéo kết quả báo cáo lớn ra khỏi hệ sinh thái Cloud. | Tối ưu băng thông mạng. Kéo file từ S3 qua mạng nội bộ hoặc giao thức HTTP Range Requests chỉ tải các Byte cần thiết. |
| Quản trị vận hành | Yêu cầu thiết lập IAM, Network, cấu hình Cluster. | Chỉ dùng một file nhị phân (Binary). Không cần cài đặt chuỗi thư viện phụ thuộc rườm rà. |
Cấu hình VPS yêu cầu & kiến trúc tiết kiệm (ARM64, NVMe)
Để chạy mượt workload phân tích, phần cứng đóng vai trò hạt nhân. Việc tối ưu không nằm ở việc vung tiền mua VPS có dung lượng RAM lớn, mà nằm ở việc hiểu nguyên lý Out-of-Core Processing.
Ổ cứng NVMe (cơ chế Spill-to-disk)
Khi bạn thực thi một câu lệnh JOIN phức tạp trên tập dữ liệu 100GB nhưng VPS chỉ có 16GB RAM, DuckDB sử dụng Buffer Manager để xử lý. Thay vì báo lỗi Out-of-Memory (OOM) và crash hệ thống, DuckDB chủ động kích hoạt tính năng Spilling to Disk (Ghi tràn ra đĩa).
Lúc này, các bảng băm trung gian sẽ được ghi tạm xuống ổ cứng. Nếu VPS dùng HDD hoặc SSD chuẩn cũ (SATA), tốc độ IOPS thấp sẽ tạo ra nút thắt cổ chai, khiến truy vấn bị treo. Do đó, ổ cứng SSD NVMe cục bộ là lựa chọn mang lại hiệu suất cao. NVMe biến đĩa cứng thành vùng bộ nhớ mở rộng tốc độ cao, cho phép tráo đổi dữ liệu với RAM ở độ trễ thấp.
Ưu tiên VPS ARM64 (Ampere/Graviton)
Động cơ thực thi của DuckDB tương thích sâu với kiến trúc ARM64 (AArch64) mà không cần qua lớp giả lập.
Các dòng chip ARM64 (như Ampere Altra trên các Cloud Provider hoặc Graviton trên AWS) cung cấp số lượng lõi vật lý thực, phù hợp cho cơ chế phân luồng Morsel-Driven của DuckDB. Đồng thời, VPS chạy ARM64 thường có giá thuê rẻ hơn từ 20% đến 40% so với kiến trúc x86_64 cùng cấu hình. Kết hợp với việc cấu hình VPS Ubuntu tiêu chuẩn, bạn sẽ có môi trường ổn định, đáp ứng đủ yêu cầu thư viện Glibc hiện hành.
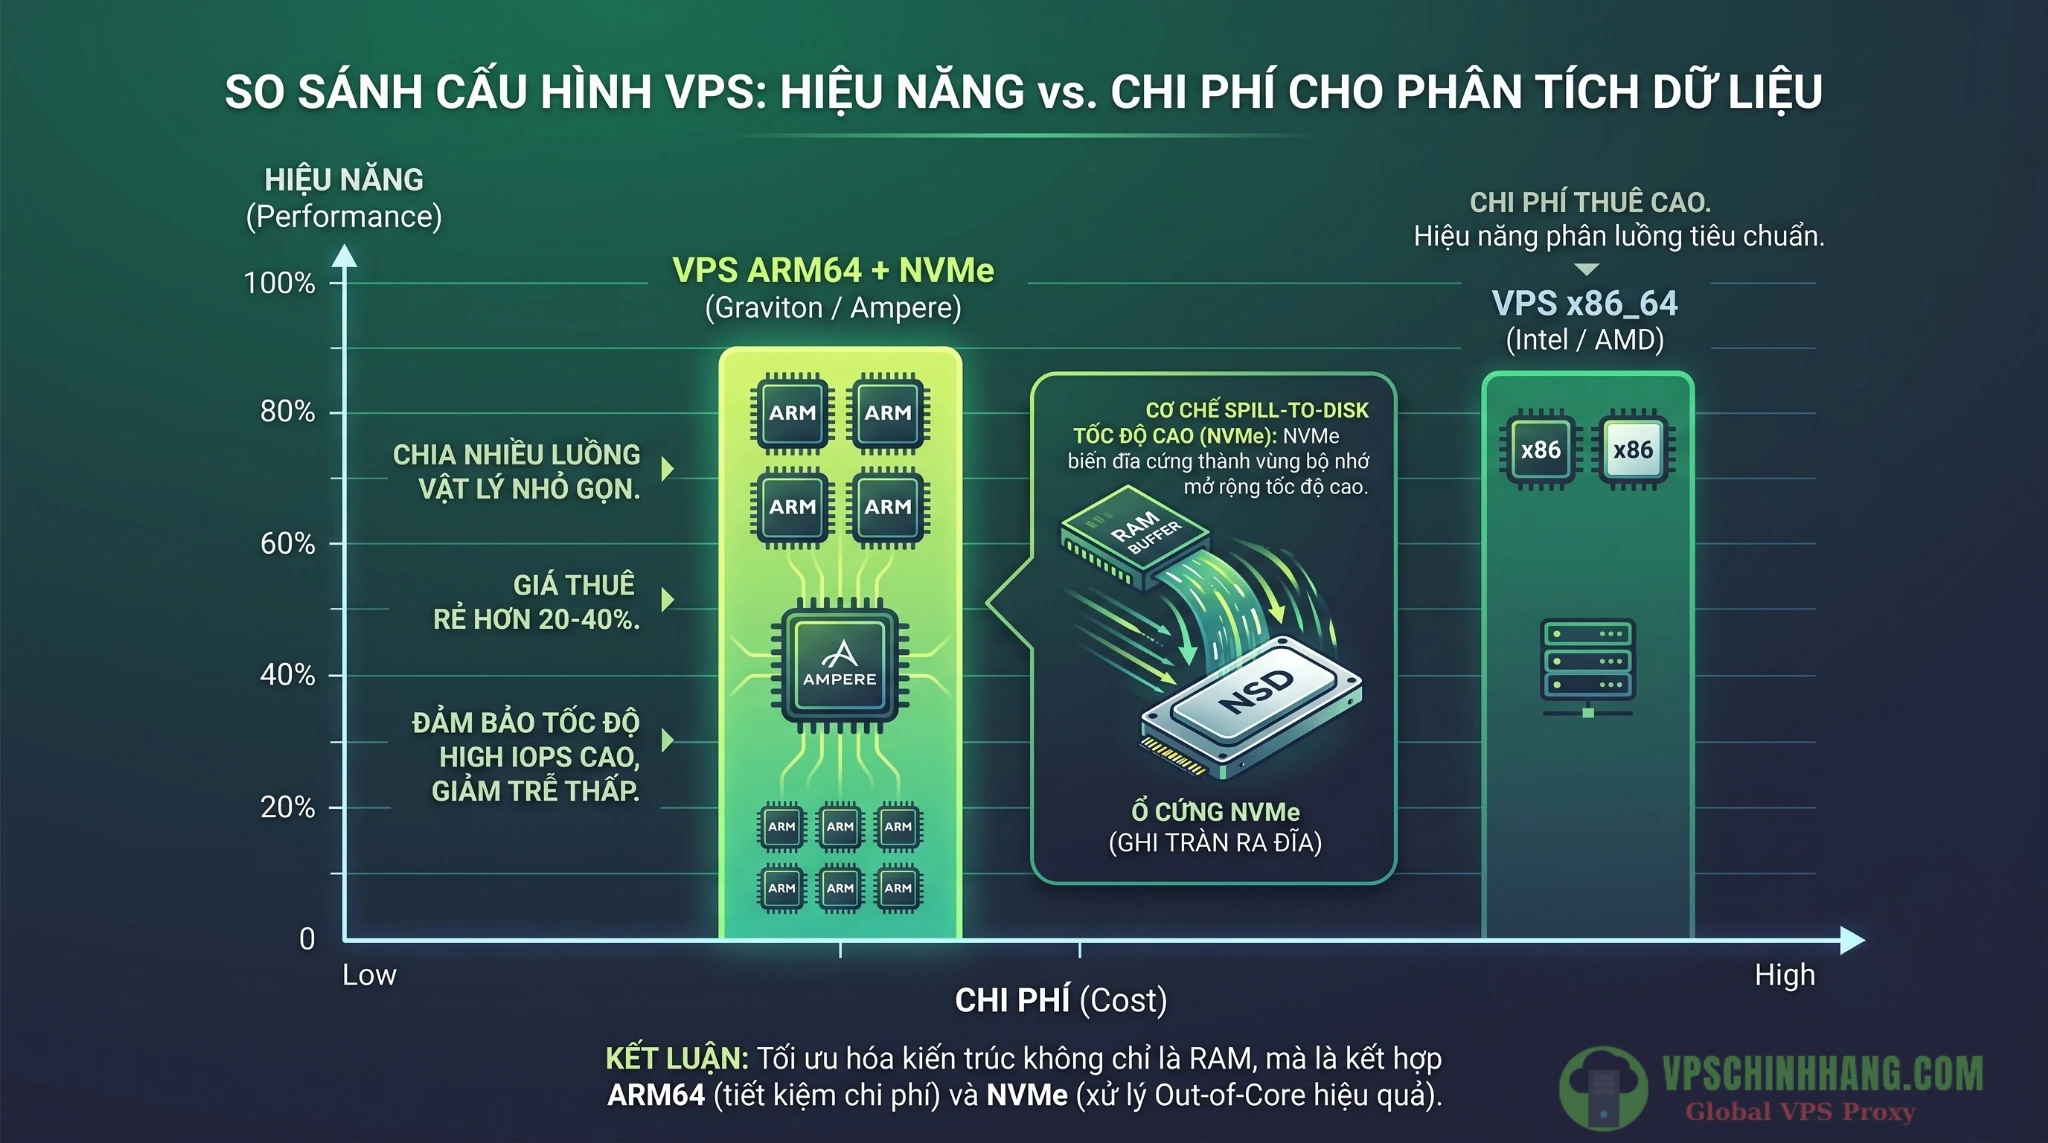
Lựa chọn VPS kiến trúc ARM64 kết hợp ổ cứng NVMe mang lại hiệu quả kinh tế cao cho các tác vụ xử lý dữ liệu lớn.
Hướng dẫn cài đặt DuckDB trên VPS Linux chi tiết
Quá trình cài đặt DuckDB trên VPS diễn ra nhanh chóng vì không yêu cầu thiết lập service nền hay file cấu hình phức tạp. Dưới đây là các bước thao tác trực tiếp trên Ubuntu.
Bước 1: Tải và thiết lập Binary bằng Official Script
Kết nối SSH vào VPS của bạn và cập nhật thư viện hệ thống:
sudo apt update && sudo apt upgrade -y
sudo apt install -y curl unzip
Sử dụng script để tải bản Binary tương thích tự động (hỗ trợ cả AMD64 và ARM64):
curl https://install.duckdb.org | bashScript này sẽ đẩy tệp nhị phân về thư mục ~/.duckdb/cli/latest/duckdb.
Bước 2: Cấu hình biến môi trường (PATH)
Để gọi lệnh duckdb trực tiếp từ bất kỳ thư mục nào, bạn thêm đường dẫn vào biến môi trường:
echo 'export PATH="$HOME/.duckdb/cli/latest:$PATH"' >> ~/.bashrc
source ~/.bashrc
Kiểm tra trạng thái hệ thống:
duckdb --versionHệ thống sẽ trả về phiên bản hiện hành (ví dụ: v1.5.5), xác nhận quá trình hoàn tất.
Bước 3: Bảo mật cơ bản cho file dữ liệu
Vì DuckDB xử lý dữ liệu qua file vật lý thay vì mở cổng kết nối Database, để tăng cường bảo mật VPS Linux, bạn cần thiết lập quyền đọc/ghi ở cấp độ hệ điều hành.
Tạo thư mục chứa dữ liệu phân tích:
sudo mkdir -p /srv/analytics
sudo chown -R $USER:$USER /srv/analytics
chmod 700 /srv/analytics
Bật tường lửa UFW, mở port SSH (Port 22):
sudo ufw allow OpenSSH
sudo ufw enable
(Nếu bạn chưa quen với việc điều hướng các rule bảo mật mạng, hãy tham khảo thêm tài liệu cấu hình UFW Ubuntu để làm chủ hệ thống Firewall này).
Xử lý dữ liệu không cần bước ETL
Giá trị ứng dụng của VPS chạy DuckDB lộ diện khi bạn lược bỏ được chu trình ETL (Extract, Transform, Load) trung gian. Developer không cần phải INSERT dữ liệu vào Database trước khi query.
Đọc trực tiếp Parquet/CSV và sức mạnh của Columnar Storage
Định dạng Parquet lưu trữ dữ liệu theo cột và được nén (Compression) sẵn. Truy vấn một file Parquet 50GB trên DuckDB diễn ra trơn tru nhờ cơ chế Projection Pushdown (Đẩy lùi phép chiếu). Nếu bảng có 100 cột, nhưng câu SQL chỉ SELECT 2 cột, DuckDB sẽ bỏ qua 98 cột còn lại trên ổ cứng.
Khởi động DuckDB shell:
duckdbQuery file Parquet cục bộ:
-- Query file Parquet cục bộ
SELECT category, SUM(revenue) AS total_revenue
FROM 'sales_data.parquet'
GROUP BY category
ORDER BY total_revenue DESC;
Nếu hệ thống đang xuất ra file CSV, hãy chuyển đổi sang Parquet để tăng tốc truy vấn nội bộ:
COPY (SELECT * FROM read_csv_auto('raw_logs.csv'))
TO 'optimized_logs.parquet' (FORMAT PARQUET, COMPRESSION ZSTD);
Kỹ thuật Partition Pruning (loại bỏ phân vùng)
Nếu dữ liệu được chia theo cấu trúc thư mục Hive (ví dụ: year=2026/month=08/data.parquet), DuckDB sẽ nhận diện các cấp thư mục này thành cột ảo.
SELECT product_id, COUNT(*)
FROM 'data_lake/year=*/month=*/*.parquet'
WHERE year = 2026 AND month = 8
GROUP BY product_id;
Bộ tối ưu hóa (Optimizer) sẽ chỉ quét vật lý vào thư mục của tháng 8/2026. Các thư mục của năm 2025 sẽ bị loại bỏ khỏi I/O đĩa cứng (Partition Pruning), giảm tải tài nguyên đọc ghi.
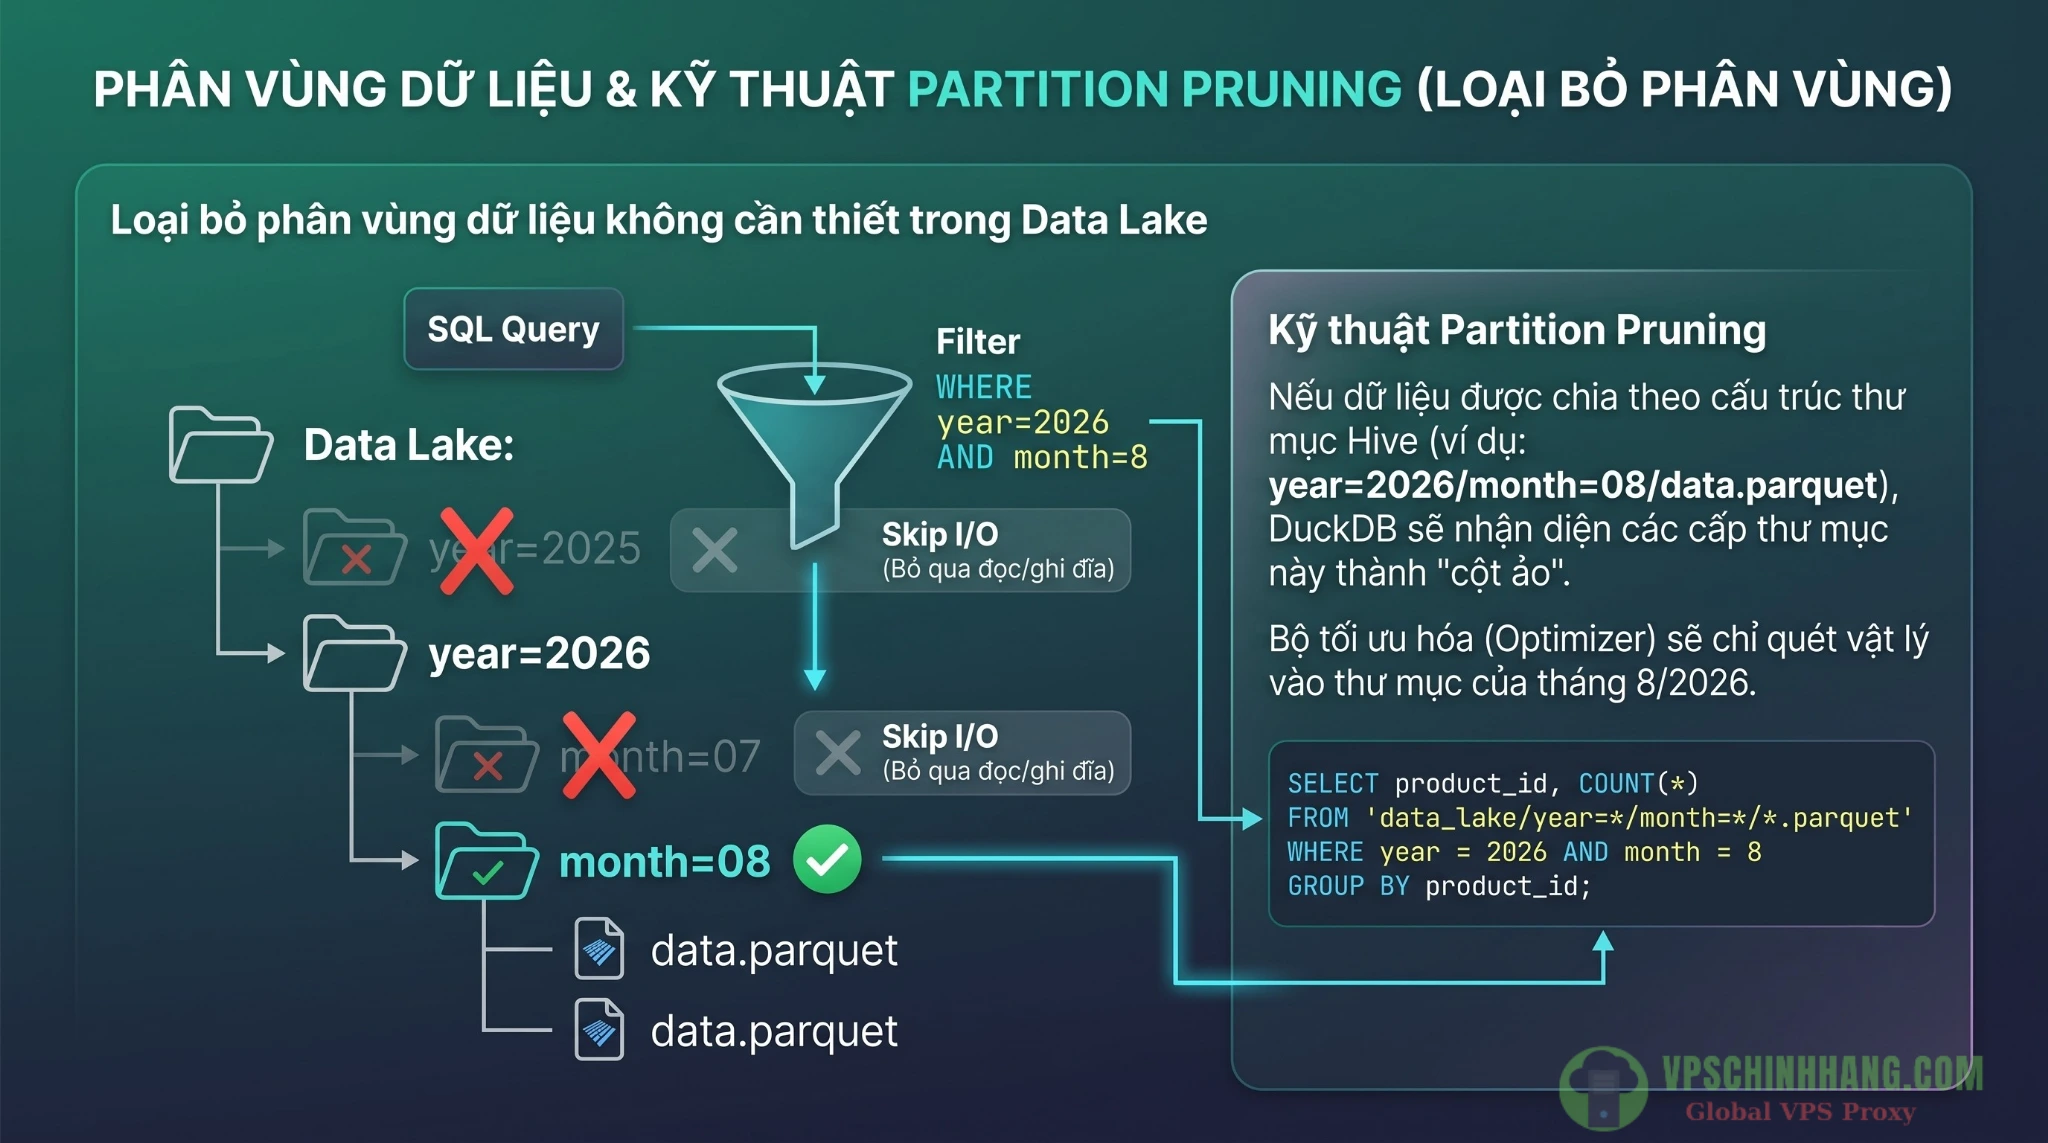
Cơ chế Partition Pruning giúp DuckDB chủ động bỏ qua các thư mục không khớp điều kiện, giảm thiểu lượng dữ liệu đọc từ ổ cứng.
Hiện đại hóa kết nối S3 với Native Extension aws
Thay vì lưu trữ file Parquet trên đĩa cứng VPS, các team data thường đặt file trên AWS S3 và query thẳng về. Từ phiên bản 1.5.3, DuckDB đã cung cấp native extension aws, giúp loại bỏ hoàn toàn việc phải khai báo Secret Key dạng plain-text rủi ro.
Thay vì dùng httpfs và khai báo thủ công, bạn chỉ cần gọi lệnh để tự động nhận diện thông tin xác thực từ môi trường (bao gồm cả chuẩn IAM Roles for Service Accounts, hay IRSA):
INSTALL aws;
LOAD aws;

-- Tự động lấy chứng chỉ bảo mật từ môi trường VPS/AWS
CALL load_aws_credentials();

-- Query trực tiếp từ bucket S3
SELECT status_code, COUNT(*)
FROM read_parquet('s3://my-company-bucket/nginx_logs/*/*.parquet')
WHERE date = '2026-08-30'
GROUP BY status_code;
Cơ chế này kết hợp với HTTP Range Requests giúp DuckDB chỉ kéo các dải Byte thỏa mãn điều kiện WHERE qua mạng, giảm lượng Egress data đáng kể.
4 tinh chỉnh quan trọng tránh bị crash (OOM) trên VPS nhỏ
Vận hành khối lượng dữ liệu lớn trên RAM hạn hẹp đòi hỏi kỹ thuật cấu hình khắt khe. Tránh để DuckDB chiếm trọn bộ nhớ khiến OOM Killer của Linux can thiệp.
Áp dụng các thông số sau vào đầu script SQL của bạn (Đồng thời, khuyến nghị bạn nên kết hợp các phương pháp giám sát VPS để theo dõi biểu đồ sử dụng RAM/CPU liên tục):
Giới hạn memory_limit bảo vệ hệ điều hành
Mặc định DuckDB dùng 80% RAM. Tuy nhiên, các hàm mảng hay string_agg thường nằm ngoài sự kiểm soát của Buffer Manager. Lời khuyên thực chiến là hãy thiết lập memory_limit xuống khoảng 50% RAM hệ thống.
Ví dụ VPS có 8GB RAM:
SET memory_limit = '4GB';Mức thiết lập này chừa lại không gian khoảng 4GB cho hệ điều hành. Khi xử lý mảng lớn, Buffer Manager nhận diện giới hạn và chủ động Spill-to-disk thay vì crash hệ thống.
Giới hạn Threads CPU (luồng xử lý)
Nếu VPS chạy song song các service khác (Nginx, API Backend), bạn cần kiểm soát luồng CPU. Tiêu chuẩn vận hành ổn định là duy trì 1GB đến 4GB RAM cho mỗi Thread. Nếu VPS có 4 vCPU nhưng RAM khiêm tốn, hãy hạ số lượng luồng:
SET threads = 2;Tối ưu vùng đệm tạm (Temp Directory)
Đảm bảo thư mục ghi tràn dữ liệu được trỏ vào ổ cứng NVMe. Đồng thời, vô hiệu hóa tính năng giữ nguyên thứ tự chèn (insertion order) để giảm sức ép lưu trữ trạng thái cho RAM:
SET temp_directory = '/tmp/duckdb_swap/';
SET preserve_insertion_order = false;
Bắt mạch bằng EXPLAIN ANALYZE
Trước khi đưa câu lệnh vào tự động hóa, hãy kiểm tra Execution Plan:
EXPLAIN ANALYZE
SELECT ... FROM ... GROUP BY ...;
Kết quả sẽ bóc tách thời gian thực thi: Khâu Hash Join tiêu tốn bao nhiêu RAM? Giai đoạn quét file mất bao nhiêu I/O? Bạn sẽ xác định được nút thắt hiệu năng nằm ở CPU hay đĩa cứng.
Trải nghiệm giao thức Quack: Biến DuckDB thành Server
Giới hạn chỉ chạy In-process của DuckDB đã được tháo gỡ nhờ bản phát hành Quack Remote Protocol (có mặt từ phiên bản 1.5.x).
Quack là giao thức gọi hàm từ xa (RPC) vận hành qua HTTP (Port mặc định 9494). Tính năng này biến VPS của bạn thành một điểm điều phối (Server), nơi các Data Analyst có thể dùng máy tính cá nhân kết nối vào, query và nhận kết quả trả về trong một vòng lặp mạng (Single Round-Trip) qua định dạng tuần tự hóa application/duckdb nguyên bản.
Khởi chạy trên VPS (Server):
INSTALL quack;
LOAD quack;

-- Khởi động endpoint với Token bảo mật, cho phép kết nối ngoại tuyến
CALL quack_serve('quack:0.0.0.0:9494', token => 'token_bao_mat_chuan', allow_other_hostname => true);
Truy vấn từ máy trạm (Client):
INSTALL quack;
LOAD quack;

-- Gắn Remote Catalog của VPS vào local
CREATE SECRET (TYPE quack, TOKEN 'token_bao_mat_chuan');
ATTACH 'quack:IP_CUA_VPS:9494' AS remote_vps;

-- Query bảng dữ liệu đang nằm trên VPS
SELECT * FROM remote_vps.analytics_table LIMIT 10;
Giao thức Quack lược bỏ chi phí ép kiểu/phân tách dữ liệu trung gian, đáp ứng hiệu năng cao cho các Dashboard BI cần trích xuất trực tiếp dữ liệu từ máy chủ.
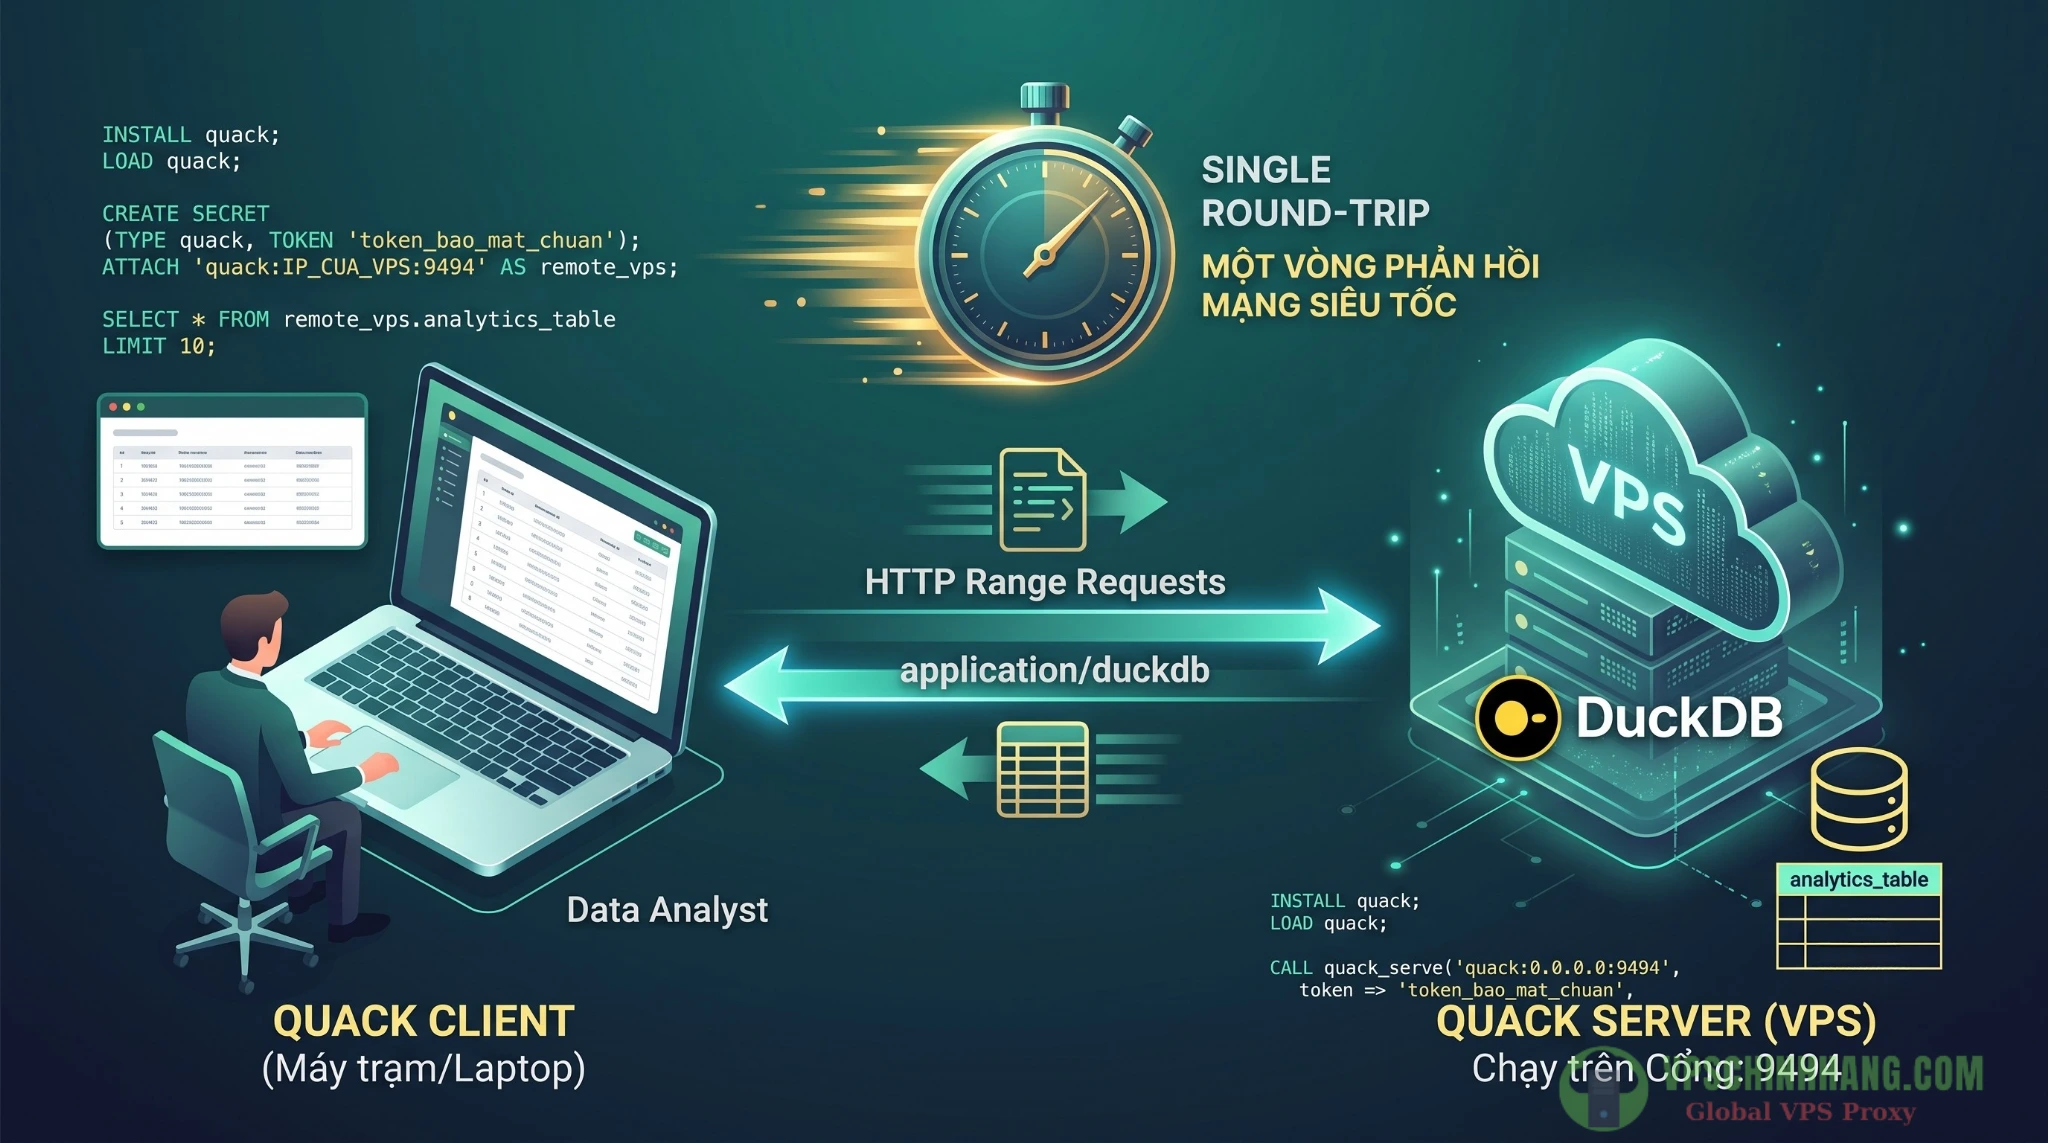
Giao thức Quack cho phép kết nối máy trạm phân tích với máy chủ VPS chỉ qua một vòng phản hồi mạng (Single Round-Trip).
Câu hỏi thường gặp (FAQ)
1. DuckDB có thể thay thế PostgreSQL/MySQL để làm Database chính chạy web không?
Không. DuckDB là công cụ chuyên xử lý phân tích dữ liệu (OLAP) và đọc file (Parquet/CSV). Với ứng dụng web cần ghi hoặc cập nhật dữ liệu liên tục (OLTP), PostgreSQL hay MySQL vẫn là lựa chọn đúng công năng.
2. Cấu hình VPS bao nhiêu là đủ để cài đặt DuckDB?
Mức thử nghiệm cơ bản là 1 đến 2 vCPU và 2GB RAM. Để xử lý mượt mà tập dữ liệu vài chục GB, cấu hình tham khảo là 4 vCPU, 8 đến 16GB RAM đi kèm ổ cứng NVMe để đáp ứng cơ chế Spill-to-disk.
3. Vì sao tiến trình DuckDB bị hệ điều hành tắt (OOM) dù đã thiết lập memory_limit?
Vì thông số memory_limit chỉ kiểm soát Buffer Manager. Các thao tác xử lý mảng (array) hoặc hàm string_agg() hoạt động ngoài vùng này vẫn ngốn RAM. Cách khắc phục: Thiết lập memory_limit ở mức 50% tổng RAM hệ thống.
4. DuckDB có bị thương mại hóa sau khi AWS mua lại DuckLabs (8/2026) không?
Không. Đây là thương vụ thâu tóm nhân tài. Bản thân mã nguồn DuckDB vẫn do tổ chức phi lợi nhuận DuckDB Foundation quản lý độc lập và hoạt động dưới giấy phép MIT.
5. Có bắt buộc tải nguyên file Parquet từ AWS S3 về ổ cứng VPS để truy vấn không?
Không. Thông qua native extension aws và cơ chế HTTP Range Requests, DuckDB sẽ lọc và kéo trực tiếp các dải byte dữ liệu đang cần từ S3 về bộ nhớ tạm để tính toán, bỏ qua bước tải file vật lý.
Kết luận
Việc thiết lập hạ tầng phân tích không đồng nghĩa với việc phải phụ thuộc vào các cỗ máy Cloud đắt đỏ. Phương pháp cài đặt DuckDB trên VPS (kết hợp ổ NVMe và kiến trúc ARM64) cung cấp một giải pháp tinh gọn, đáp ứng hiệu suất công việc và ngăn chặn tình trạng tràn chi phí hạ tầng.
Nhờ tận dụng lưu trữ Parquet, kỹ thuật Partition Pruning, khả năng kết nối linh hoạt qua extension aws và bộ khống chế RAM chủ động, các team kỹ thuật có thể vận hành Data Pipeline trơn tru. Thêm vào đó, sự xuất hiện của giao thức Quack đang làm mờ đi ranh giới giữa kiến trúc In-process và Client/Server truyền thống.
Nếu hệ thống của bạn đang phải xử lý log hoặc báo cáo phân tích dưới 1TB, hãy khởi tạo một instance VPS Linux và áp dụng các kịch bản cấu hình trên. Việc chủ động kiểm soát quy trình và công cụ sẽ mang lại hiệu quả quản trị lâu dài cho doanh nghiệp.
Tài liệu tham khảo
Hướng dẫn bảo mật Gitea trên VPS: Vá lỗ hổng RCE (CVE-2026-60004) khẩn cấp và Hardening Git Server
Quản trị rủi ro khi nâng cấp Kubernetes 1.37 trên VPS: Xử lý Kube-DNS, cgroup v1 và legacy service