

Hướng dẫn chạy Local AI trên VPS GPU: Triển khai Qwen3.8 xử lý dữ liệu nội bộ
Đã bao giờ luồng xử lý RAG (Retrieval-Augmented Generation) của team bạn bị gián đoạn giữa chừng vì chạm ngưỡng rate-limit của các dịch vụ đám mây? Hay đội ngũ Security vừa tuýt còi dự án vì phát hiện mã nguồn và hợp đồng mật của công ty đang được đẩy lên một Public API không rõ cơ chế lưu trữ? Đó là những rào cản chực chờ khi hạ tầng dữ liệu phụ thuộc vào hệ thống của bên thứ ba.
Để xử lý bài toán này, việc chạy Local AI trên VPS (Virtual Private Server) kết hợp GPU đang trở thành phương án được nhiều kỹ sư hệ thống lựa chọn. Liệu một chiếc VPS GPU phổ thông có đủ sức gánh vác mô hình hàng chục tỷ tham số như dòng Qwen3.8, và kiến trúc phần mềm ra sao để hệ thống hoạt động mượt mà từ Backend (vLLM) đến Frontend (Open WebUI)?
Tại sao Developer ưu tiên chạy Local AI trên VPS thay vì Public API?
Việc chuyển hướng từ các dịch vụ API công cộng sang tự triển khai LLM (Large Language Model) trên máy chủ ảo mang lại nhiều lợi thế chiến lược về mặt kỹ thuật, an toàn thông tin và quản trị chi phí.
Giảm thiểu rủi ro rò rỉ dữ liệu (Data Leakage)
Khi sử dụng các Public API, dữ liệu nội bộ buộc phải truyền qua môi trường internet đến máy chủ của nhà cung cấp. Lịch sử ngành công nghệ đã ghi nhận các trường hợp mô hình AI thương mại vô tình học thuộc lòng mã nguồn hoặc các điều khoản hợp đồng được đưa vào prompt. Kẻ tấn công có thể dùng kỹ thuật Prompt Injection để ép hệ thống trả ra các thông tin nhạy cảm này.
Trái lại, tự host AI trên VPS đảm bảo quá trình suy luận (inference) diễn ra khép kín trong hạ tầng nội bộ. Dữ liệu không phát sinh kết nối ra ngoài internet, giúp ngăn chặn nguy cơ thông tin doanh nghiệp bị đưa vào quá trình huấn luyện lại mô hình (Model Re-training) của các tổ chức khác.
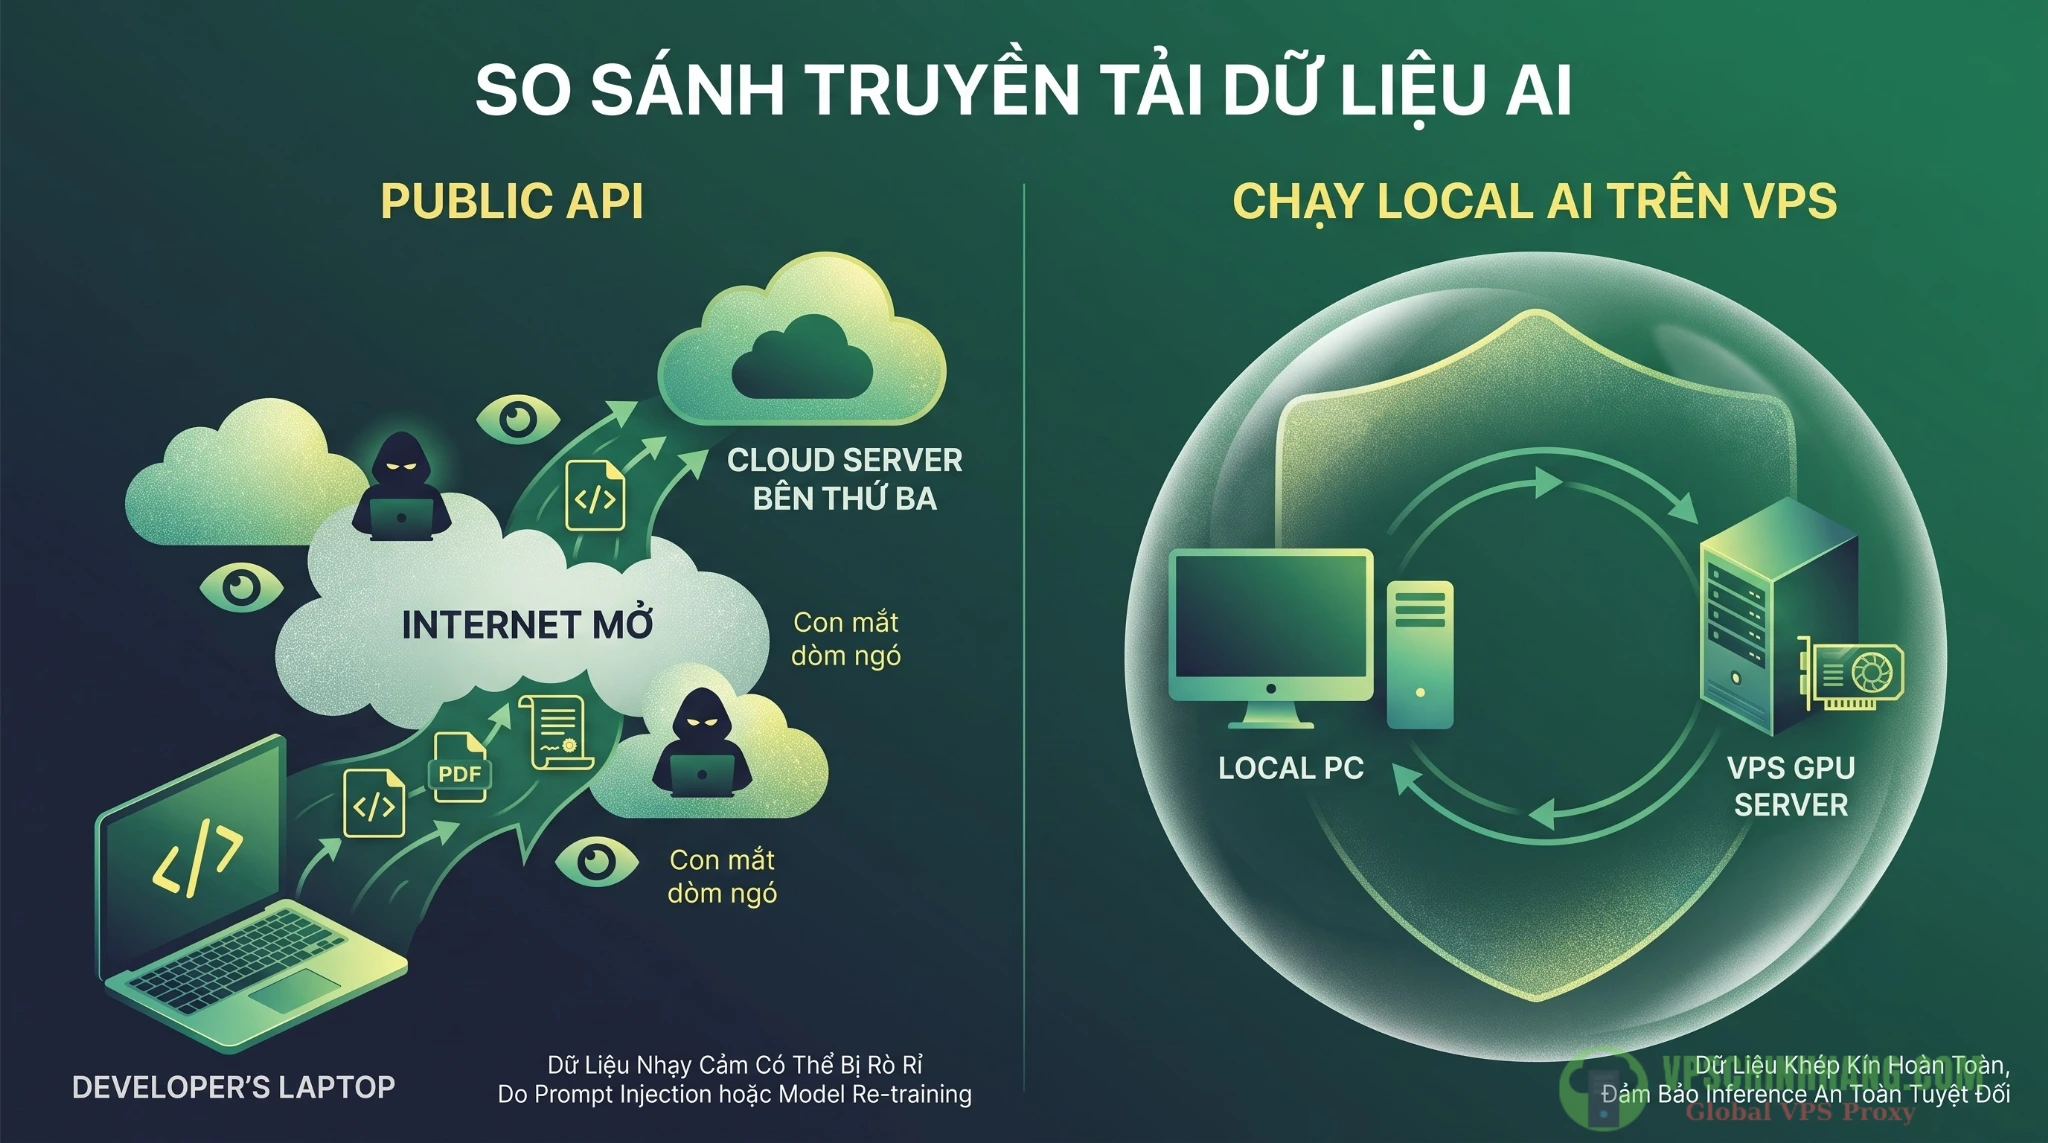
Kiến trúc xử lý khép kín khi chạy Local AI trên VPS giúp loại bỏ rủi ro rò rỉ dữ liệu nhạy cảm so với việc gửi request qua Public API.
Quản trị ngân sách và tuân thủ pháp lý
- Kinh tế học suy luận: Với API công cộng, chi phí được tính trên từng token. Ở quy mô request lớn, hóa đơn có thể tăng vọt khó kiểm soát, đặc biệt khi xử lý các tài liệu PDF dài. Đối với khối lượng công việc liên tục, việc thuê VPS GPU (như dòng card RTX 3090, 4090, hoặc 5080) theo dạng thanh toán cố định hoặc Pay-as-you-go giúp nhà quản trị dự phóng ngân sách và đo lường ROI sát thực tế.
- Tuân thủ pháp lý: Việc đẩy dữ liệu cá nhân của người dùng qua API máy chủ quốc tế đòi hỏi doanh nghiệp phải xử lý các thủ tục đánh giá tác động theo Nghị định 13/2023/NĐ-CP (Luật Bảo vệ dữ liệu cá nhân). Tự host LLM trên hạ tầng Cloud trong nước giúp đáp ứng nguyên tắc Lưu trú dữ liệu nội địa (Data Residency) và cho phép kỹ sư chủ động kiểm soát nhật ký hệ thống (System logs).
Sự thật về Qwen3.8-Max và lựa chọn thực tế cho VPS GPU
Khi Alibaba mở trọng số dòng Qwen3.8, nhiều kỹ sư đã lên kế hoạch triển khai phiên bản mang tên Qwen3.8-Max. Tuy nhiên, giới hạn vật lý của phần cứng là một rào cản kỹ thuật cần được tính toán kỹ lưỡng.
2.4 Trillion Parameters: Thách thức lớn với hạ tầng tiêu chuẩn
Qwen3.8-Max là mô hình ngôn ngữ-thị giác quy mô lớn với cấu trúc Mixture-of-Experts (MoE) gồm 2,4 nghìn tỷ tham số, kích hoạt khoảng 95 tỷ tham số cho mỗi token. Một số nhà phát triển nhầm lẫn rằng chỉ cần GPU đủ chứa phần 95B kích hoạt là có thể chạy được mô hình.
Thực tế, bộ định tuyến (router) của mô hình MoE yêu cầu toàn bộ 2,4 nghìn tỷ tham số phải thường trực (resident) trong VRAM để tránh độ trễ khi nạp dữ liệu.
- Ở định dạng FP8 (Chuẩn sản xuất): Trọng số chiếm khoảng 2,5TB VRAM.
- Để hệ thống vận hành ổn định, doanh nghiệp cần thiết lập các cụm máy chủ (GPU Clusters) trang bị NVLink (ví dụ: cụm 24x H200 hoặc 16x Blackwell B300). Một cấu hình VPS GPU đơn lẻ không đủ khả năng gánh vác khối lượng tính toán này.
Qwen3.8-27B – Lựa chọn phù hợp để chạy Local AI trên VPS
Đối với các dự án tự host (self-hosted), Qwen3.8-27B (phiên bản Dense có hỗ trợ Vision) là giải pháp cân bằng tài nguyên hiệu quả:
- Tối ưu VRAM: Trọng số của mô hình này được thiết kế để vận hành vừa vặn trên các card đồ họa phổ thông. Kỹ sư có thể tận dụng các dòng VPS sử dụng card 24GB VRAM để chạy mô hình ở các định dạng lượng tử hóa (Quantization) mà vẫn đáp ứng chất lượng đầu ra.
- Giấy phép Apache 2.0: Khác với bản Max sử dụng Custom License có các điều khoản ràng buộc thương mại quy mô lớn, Qwen3.8-27B dùng Apache 2.0, cho phép cộng đồng nhà phát triển tự do tinh chỉnh, tích hợp và đưa vào môi trường production.
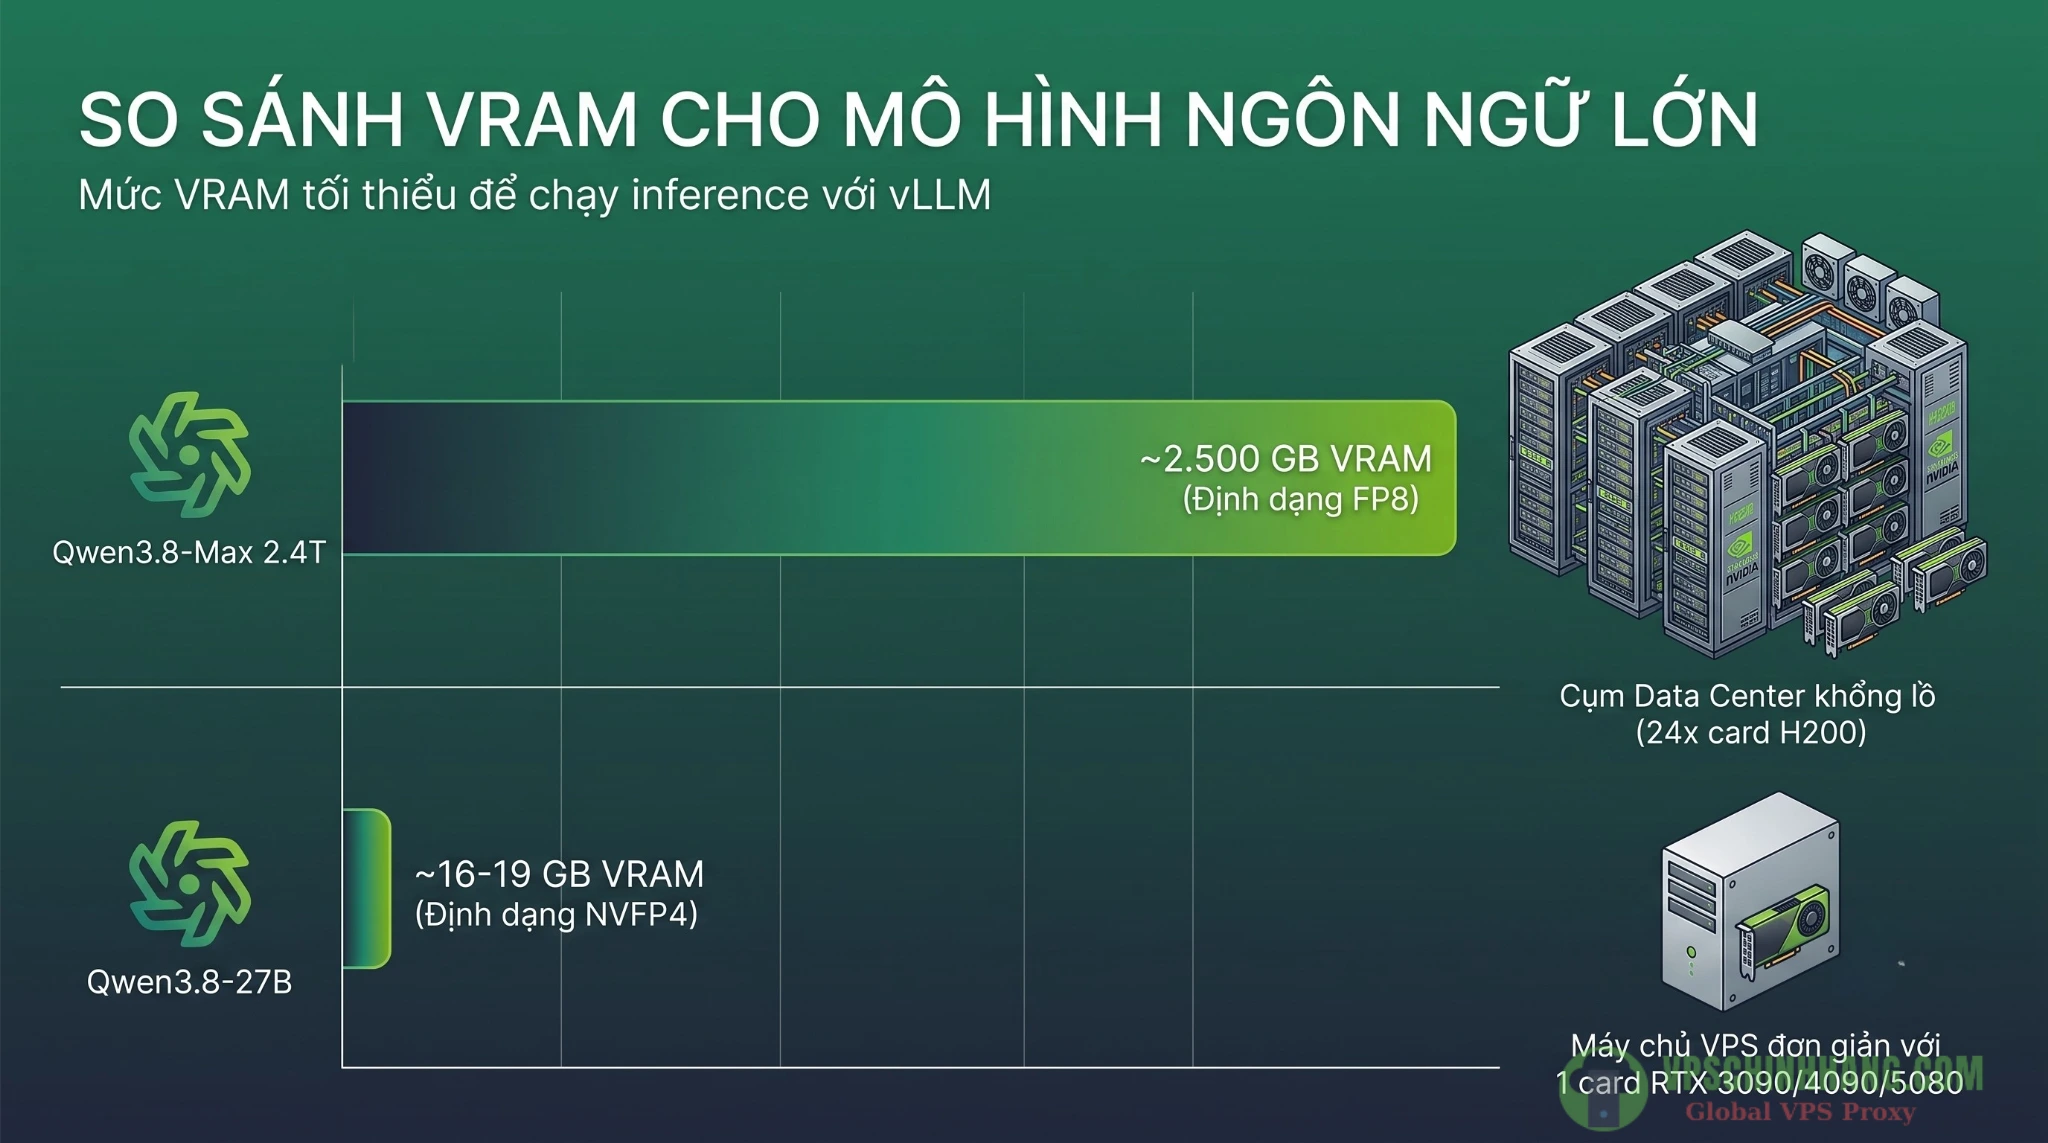
So sánh tương quan yêu cầu phần cứng VRAM giữa cụm GPU Cluster cho bản Max và VPS GPU card đơn cho bản 27B.
Hướng dẫn setup môi trường và khởi chạy vLLM qua Docker
Để vận hành mô hình ngôn ngữ lớn, việc cài đặt trực tiếp các gói thư viện trên máy chủ vật lý dễ dẫn đến rủi ro xung đột (dependency conflicts) và gây khó khăn khi cần nâng cấp phiên bản CUDA. Tiêu chuẩn của các kỹ sư hệ thống là sử dụng Docker Image của vLLM, kết hợp với NVIDIA Container Toolkit.
Cài đặt NVIDIA Container Toolkit
Hệ thống cần bộ công cụ để Docker có thể giao tiếp với nhân GPU. Mở terminal trên VPS Ubuntu/Debian và thực thi cấu hình.
Thêm kho lưu trữ của NVIDIA:
curl -fsSL https://nvidia.github.io/libnvidia-container/gpgkey | sudo gpg --dearmor -o /usr/share/keyrings/nvidia-container-toolkit-keyring.gpg \
  && curl -s -L https://nvidia.github.io/libnvidia-container/stable/deb/nvidia-container-toolkit.list | \
    sed 's#deb https://#deb [signed-by=/usr/share/keyrings/nvidia-container-toolkit-keyring.gpg] https://#g' | \
    sudo tee /etc/apt/sources.list.d/nvidia-container-toolkit.list
Cài đặt toolkit và cấu hình runtime cho Docker:
sudo apt-get update && sudo apt-get install -y nvidia-container-toolkit
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
Khởi chạy Qwen3.8-27B với Docker vLLM (Tối ưu hóa kiến trúc)
Thay vì sử dụng các cấu hình mặc định dễ gây lỗi tràn VRAM (CUDA OOM), chúng ta sẽ tích hợp các công nghệ xử lý bộ nhớ và biến môi trường tương thích vào lệnh docker run:
docker run --runtime nvidia --gpus all \
    -v ~/.cache/huggingface:/root/.cache/huggingface \
    -p 127.0.0.1:8000:8000 \
    --ipc=host \
    -e VLLM_API_KEY="your-secret-token" \
    --env "VLLM_ENABLE_CUDA_COMPATIBILITY=1" \
    vllm/vllm-openai:cu130-nightly \
    --model unsloth/Qwen3.8-27B-NVFP4 \
    --quantization nvfp4 \
    --kv-cache-dtype nvfp4 \
    --reasoning-parser qwen3 \
    --enable-prefix-caching \
    --swap-space 16 \
    --gpu-memory-utilization 0.85
Giải phẫu các tham số kỹ thuật trong lệnh khởi chạy:
--env "VLLM_ENABLE_CUDA_COMPATIBILITY=1": Biến môi trường này giúp container vLLM chạy ổn định ngay cả khi hệ điều hành host đang sử dụng phiên bản NVIDIA driver cũ chưa kịp nâng cấp.vllm/vllm-openai:cu130-nightly: Sử dụng image có build CUDA 13.0 để đảm bảo phần cứng kiến trúc mới nhận diện trình điều khiển mượt mà.--model unsloth/Qwen3.8-27B-NVFP4: Trỏ đến kho lưu trữ chứa phiên bản đã được lượng tử hóa NVFP4, hỗ trợ tối ưu băng thông tải xuống.--quantization nvfp4&--kv-cache-dtype nvfp4: Định dạng lượng tử hóa này giúp mô hình chạy nhanh hơn và giảm dung lượng VRAM cho KV Cache thêm 50% so với chuẩn FP8 (Lưu ý: Chỉ khả dụng trên kiến trúc card Blackwell).--swap-space 16: Thiết lập 16GB RAM hệ thống làm bộ đệm phụ (CPU Offloading). Khi VRAM chứa KV Cache có dấu hiệu đầy, các block ưu tiên thấp sẽ tự động chuyển sang RAM, ngăn chặn lỗi OOM.--reasoning-parser qwen3: Cấu hình bắt buộc cho Hybrid Thinking. Qwen3.8-27B là mô hình tư duy lai. Cờ này giúp engine vLLM phân tách rành mạch các token suy luận (thinking traces) và câu trả lời cuối cùng, từ đó Frontend có thể ẩn quá trình suy nghĩ đi để mang lại trải nghiệm gọn gàng cho người dùng.--enable-prefix-caching: Tái sử dụng KV Cache cho các prompt có phần mở đầu giống nhau, hỗ trợ giảm độ trễ First-Token (TTFT).
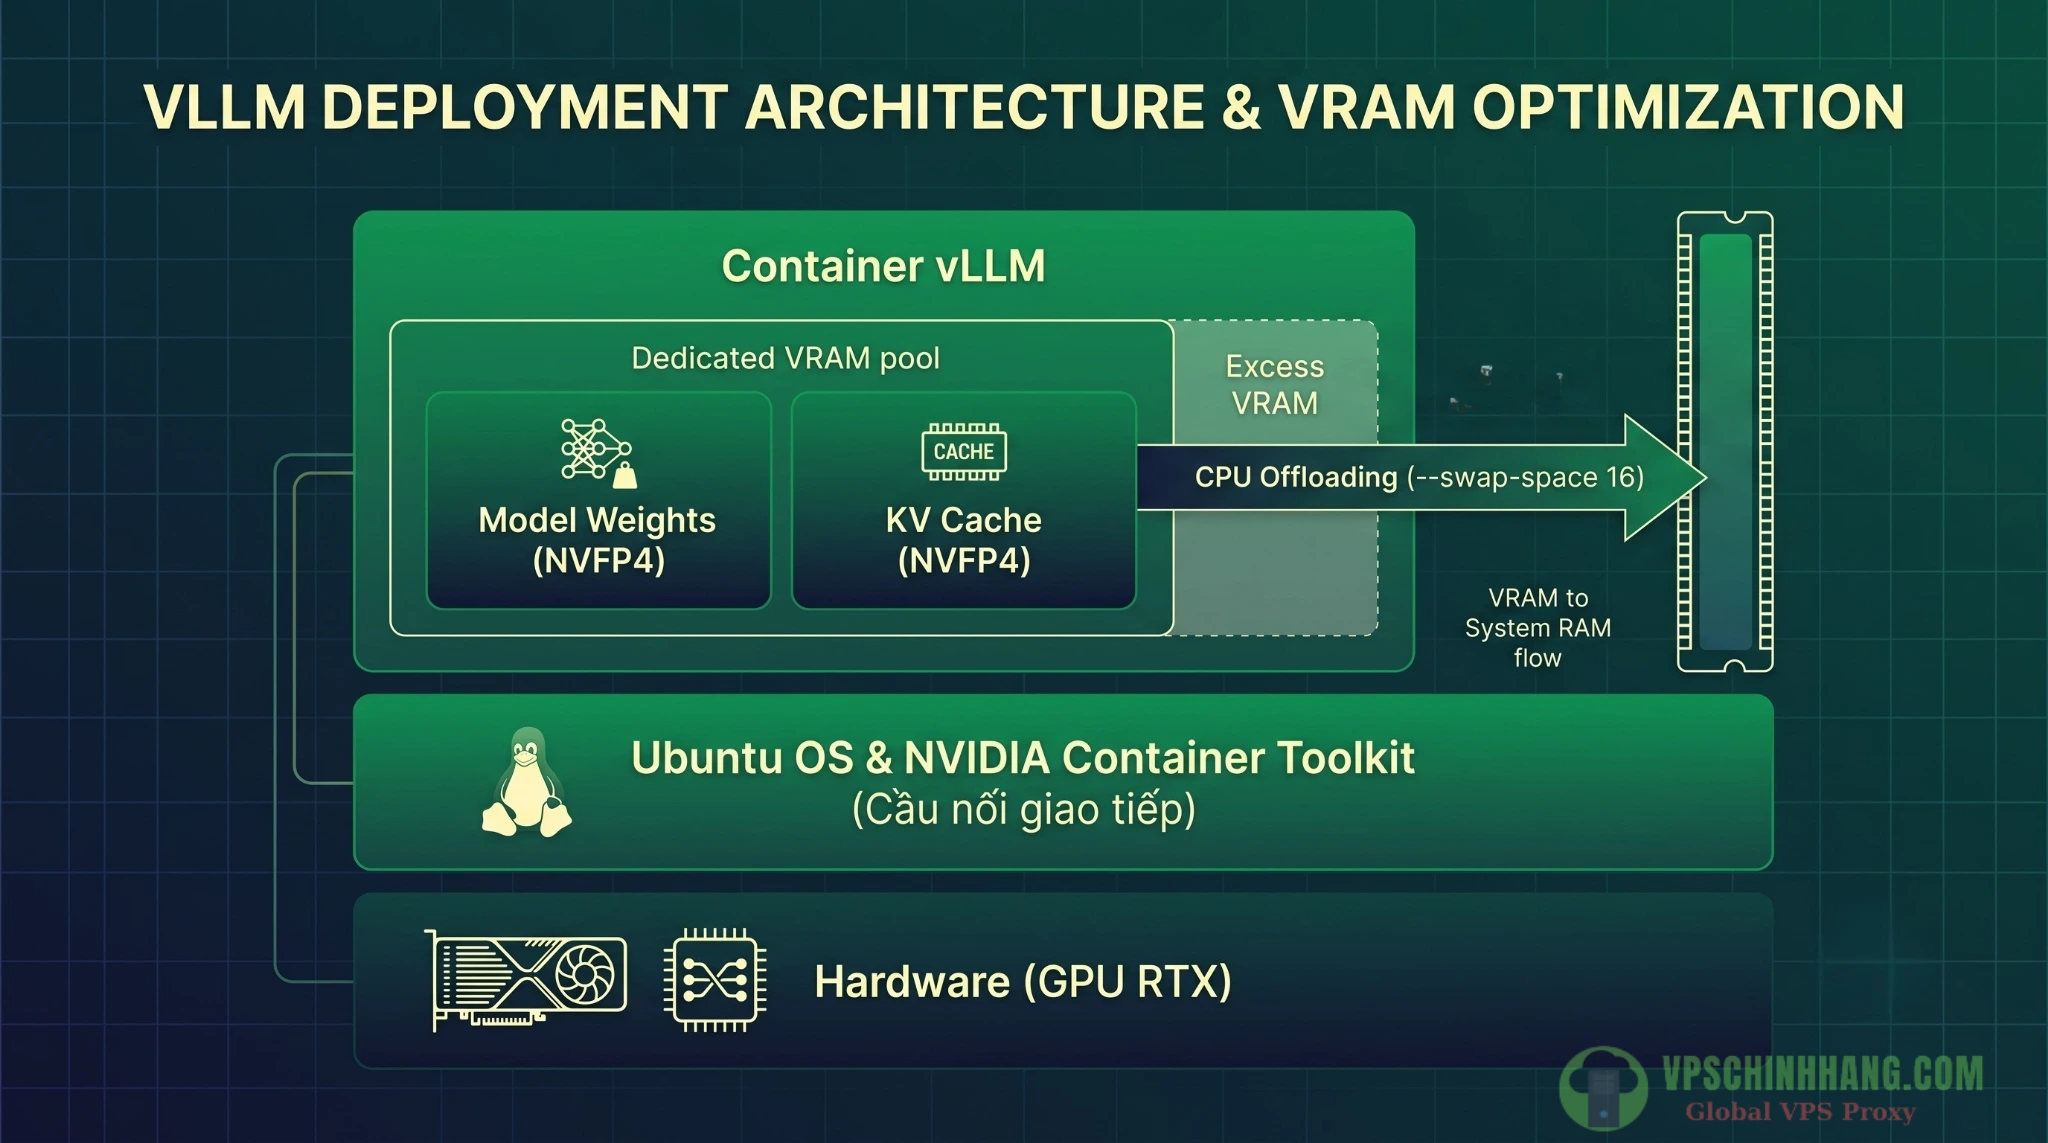
Mô hình phân bổ tài nguyên bộ nhớ thông minh của vLLM kết hợp kỹ thuật lượng tử hóa NVFP4 và tính năng CPU Offloading.
Ứng dụng thực tế: Triển khai Open WebUI làm Frontend cho team
Sau khi API backend đã hoạt động ổn định, bài toán tiếp theo là cung cấp một giao diện sử dụng cho các phòng ban non-tech (như HR, Pháp chế, Marketing). Thay vì yêu cầu người dùng cài đặt ứng dụng cục bộ, giải pháp hiệu quả là triển khai Open WebUI.
Open WebUI là một nền tảng giao diện web mã nguồn mở, mang lại trải nghiệm trò chuyện tương tự các chatbot thương mại và đóng vai trò như cầu nối giữa người dùng nội bộ và máy chủ vLLM.
Tích hợp Open WebUI với vLLM API
Khi được triển khai thông qua Docker trên cùng máy chủ VPS hoặc một server nội bộ khác, Open WebUI mang lại các tính năng vận hành chuyên sâu:
- Kết nối OpenAI-Compatible: Trong phần quản trị của Open WebUI, bạn điều hướng đến mục kết nối API, điền URL nội bộ của vLLM (ví dụ:
http://10.x.x.x:8000/v1) và nhậpVLLM_API_KEY. - Xử lý tài liệu (Built-in RAG): Nền tảng này tích hợp sẵn bộ máy Vector Database (như ChromaDB). Người dùng có thể kéo thả các tệp PDF/DOCX trực tiếp vào khung chat. Open WebUI sẽ tự động bóc tách văn bản, chia nhỏ (chunking) và gửi truy vấn RAG đến Qwen3.8-27B mà không đòi hỏi việc lập trình thêm middleware.
- Quản lý phân quyền: Hỗ trợ tạo tài khoản riêng cho từng nhân viên, lưu trữ lịch sử chat độc lập và ẩn đi các chuỗi suy luận (thinking traces) nhờ vào cờ
--reasoning-parserđã cấu hình ở backend.
Bảo mật Endpoint: Chạy local cần cấu hình Zero Trust
Một lỗi cấu hình thường gặp của các sysadmin là ánh xạ cổng vLLM hoặc Open WebUI trực tiếp ra IP Public. Điều này khiến VPS GPU trở thành mục tiêu của các cuộc quét cổng tự động và gặp rủi ro cạn kiệt tài nguyên (Cost-exhaustion). Kiến trúc mạng cần được thiết lập chặt chẽ hơn.
Bind Localhost và thiết lập mạng ảo (Tailscale/WireGuard)
- Localhost Binding: Các dịch vụ backend (vLLM ở port 8000) và frontend (Open WebUI ở port 8080) cần được cấu hình lắng nghe trên IP cục bộ
127.0.0.1để tránh bị lộ ra ngoài. - Mạng nội bộ ảo: Triển khai Tailscale hoặc WireGuard để tạo đường hầm VPN. Cùng với đó, cấu hình tường lửa UFW để drop toàn bộ các gói tin lạ. Người dùng nội bộ sẽ truy cập vào giao diện web thông qua địa chỉ IP riêng của VPN (ví dụ:
100.115.120.130), chặn đứng mọi kết nối từ internet công cộng.
Cấu hình Nginx điều hướng Frontend và duy trì WebSocket
Trong mô hình Client-Server chuẩn, Nginx sẽ đóng vai trò Gateway tiếp nhận request từ mạng VPN và phân luồng trực tiếp vào giao diện Open WebUI. Để giao diện trò chuyện hoạt động trơn tru, Nginx cần duy trì các giao thức WebSocket và Server-Sent Events (SSE), đồng thời mở rộng kích thước tải lên để phục vụ tính năng RAG.
Bạn cần thiết lập file cấu hình Nginx như sau:
server {
    # Lắng nghe trên IP của mạng VPN nội bộ
    listen 100.115.120.130:443 ssl http2;
    server_name chat.internal.example.com; # Tên miền cho giao diện UI

    # Cấu hình chứng chỉ SSL nội bộ...

    location / {
        # Proxy trực tiếp vào port mặc định của Open WebUI (8080)
        proxy_pass http://127.0.0.1:8080;

        # Khai báo để duy trì WebSocket (dùng cho chat) và Server-Sent Events (SSE)
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
        proxy_buffering off;
        proxy_cache off;

        # Truyền thông tin client gốc
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;

        proxy_read_timeout 600s;

        # Tăng body size lên 100MB để user có thể upload file PDF/Excel lớn vào RAG
        client_max_body_size 100m;
    }
}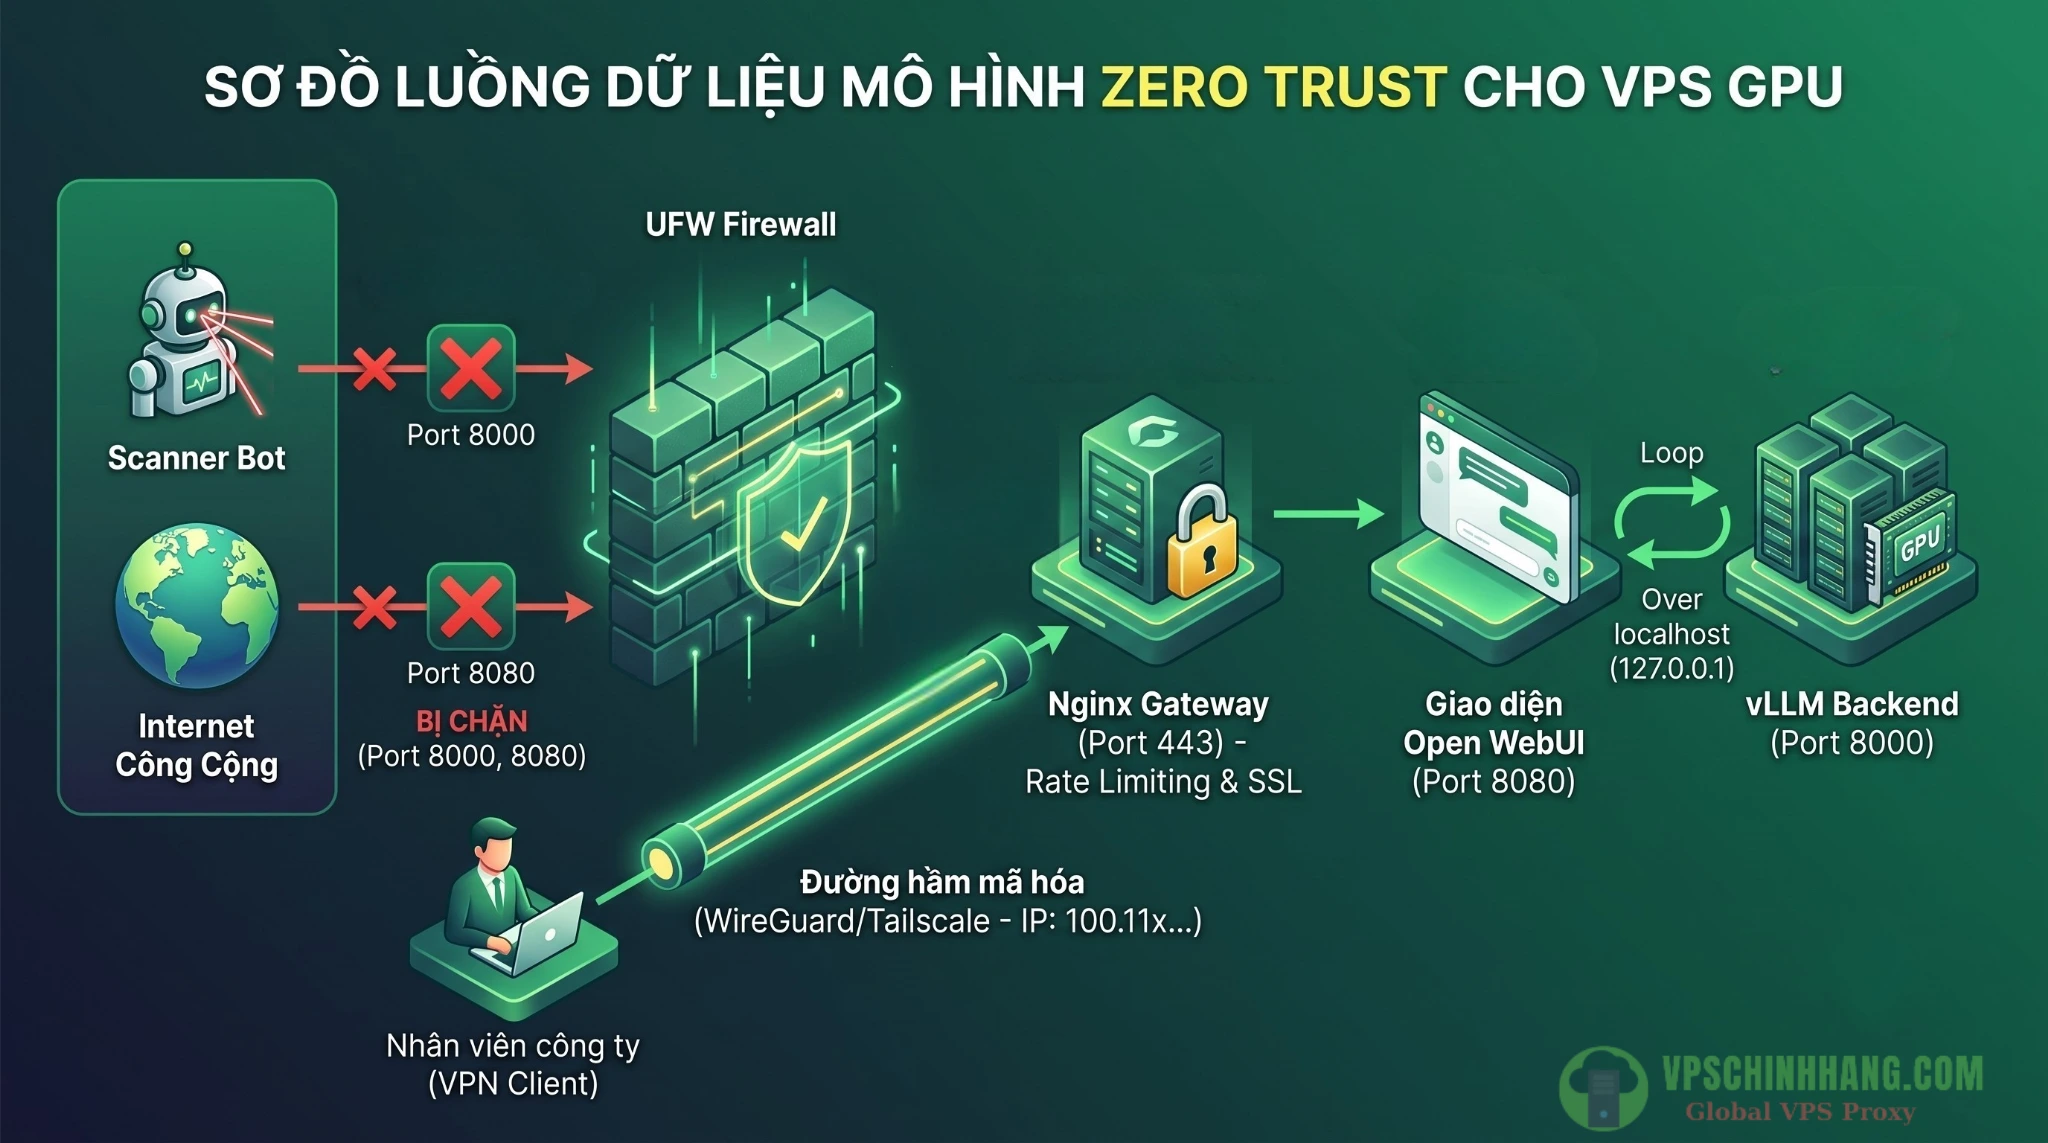
Luồng truy cập an toàn (Zero Trust) chặn đứng kết nối trực tiếp từ internet, bảo vệ VPS GPU khỏi các cuộc tấn công vắt kiệt tài nguyên.
Câu hỏi thường gặp (FAQ)
1. Cần bao nhiêu VRAM để chạy Qwen3.8-27B?
Khoảng 16-19GB VRAM. Một máy chủ ảo VPS trang bị 1 card GPU 24GB (như RTX 3090, RTX 4090 hoặc RTX 5080) là đủ không gian để chạy định dạng lượng tử hóa 4-bit (NVFP4/AWQ) và chừa lại bộ đệm cho KV Cache.
2. Có thể chạy bản Qwen3.8-Max trên một VPS đơn lẻ không?
Không. Bản Max (2.4T tham số) đòi hỏi khoảng 2.5TB VRAM ở định dạng FP8. Cấu hình này yêu cầu một cụm máy chủ Data Center chuyên dụng (Ví dụ: 16x B300 hoặc 24x H200), vượt quá khả năng của bất kỳ VPS độc lập nào.
3. Nên dùng hệ điều hành nào để làm máy chủ host AI?
Ubuntu 22.04 LTS hoặc 24.04 LTS là lựa chọn phổ biến, tương thích ổn định với các bản cập nhật driver từ NVIDIA và thuận tiện cho quy trình cài đặt Docker trên VPS Ubuntu dành cho người mới bắt đầu cũng trở nên dễ dàng hơn.
4. Tại sao phải chặn cổng giao tiếp vLLM (Port 8000) bằng VPN?
Để chống lại các cuộc tấn công vắt kiệt tài nguyên (Cost-exhaustion) và rà quét port từ botnet. Việc sử dụng giải pháp VPN WireGuard hoặc Tailscale sẽ đưa hệ thống vào mạng nội bộ, chỉ những thiết bị được xác thực mới có quyền truy cập.
5. Open WebUI xử lý file PDF nội bộ (RAG) như thế nào?
Open WebUI được tích hợp sẵn Vector Database (như ChromaDB) ở backend. Khi người dùng kéo thả file PDF vào giao diện chat, hệ thống tự động bóc tách, chia nhỏ văn bản và nhúng ngữ cảnh vào truy vấn gửi cho LLM mà kỹ sư không cần phải viết thêm dòng code nào.
Kết luận
Bằng cách kết hợp linh hoạt sức mạnh phần cứng của máy chủ ảo, hệ sinh thái container Docker và giao diện Open WebUI, việc chạy Local AI trên VPS sẽ thiết lập một luồng xử lý thông tin mạch lạc, bảo mật. Qwen3.8-27B, khi được ứng dụng kỹ thuật lượng tử hóa, tối ưu bộ đệm KV Cache và cấu hình Nginx định tuyến chính xác, hoàn toàn đáp ứng vai trò trung tâm phân tích dữ liệu, hoạt động bền bỉ trong hạ tầng của doanh nghiệp.
Tài liệu tham khảo
Hướng dẫn tối ưu web Dropship trên VPS: Giảm tải Database bằng Redis Cache (2026)
Hướng dẫn cấu hình Egress Proxy trên VPS Linux: Quản lý request API, tránh Rate-Limit (2026)