

Hướng dẫn tối ưu bộ nhớ Rust 1.100 Cloud Server: Dùng Allocator API cắt đứt nỗi lo OOM
Developer backend chắc hẳn không còn xa lạ với viễn cảnh đang chìm trong giấc ngủ thì hệ thống PagerDuty réo ầm ĩ. Bạn bật vội laptop, mở dashboard giám sát và thấy biểu đồ memory spike tạo thành một cột thẳng đứng. Vài giây sau, pod bị Kubernetes bắn bỏ không thương tiếc với một dòng log lạnh lùng: OOMKilled (Exit code 137).
Rõ ràng chúng ta đang lập trình bằng Rust, một ngôn ngữ nổi danh về sự an toàn bộ nhớ (memory-safe), không có lỗi data race hay use-after-free, vậy tại sao ứng dụng vẫn cạn kiệt RAM và sập cái rụp? Thực tế phũ phàng ở đây là: code an toàn bộ nhớ không đồng nghĩa với việc dung lượng RAM là vô hạn. Việc giữ lại các tham chiếu không cần thiết, nạp một cục payload khổng lồ vào bộ nhớ, hay sự phân mảnh (fragmentation) của hệ thống cấp phát đều có thể kéo sập ứng dụng trong chớp mắt.
Đó là lý do kỹ sư hệ thống cần trang bị kỹ năng tối ưu bộ nhớ Rust 1.100 Cloud Server để làm chủ hoàn toàn cách ứng dụng xin và trả tài nguyên. Làm thế nào để ứng dụng tự vệ trước những đợt traffic đột biến? Đâu là phương pháp để Rust nhả RAM về cho hệ điều hành kịp thời trước khi bị kernel trừng phạt?
Nỗi đau OOMKilled (Exit code 137) dù code Rust đã memory-safe
Để trị dứt điểm căn bệnh, chúng ta phải bắt đúng mạch. Rất nhiều developer thắc mắc tại sao Rust an toàn nhưng vẫn dính lỗi Out of Memory (OOM). Vấn đề nằm ở sự chênh lệch giữa cách Rust cấp phát RAM ở tầng user-space và cách hệ điều hành Linux quản lý tài nguyên ở tầng kernel.
Sự thật về giới hạn tài nguyên và memory safety
Cơ chế ownership (sở hữu) và borrowing (mượn) của Rust sinh ra để loại bỏ các lỗi memory corruption tại thời điểm biên dịch (compile-time). Tuy nhiên, trình biên dịch không thể cấm bạn đọc toàn bộ file log kích thước 5GB vào một biến Vec<u8> trên máy chủ chỉ có 2GB RAM.
Việc rò rỉ bộ nhớ (memory leak) hoàn toàn có thể xảy ra một cách hợp lệ trong mã safe Rust. Ví dụ, bạn có thể vô tình tạo ra các vòng lặp tham chiếu khi dùng Arc/Rc kết hợp với interior mutability, hoặc thiết kế các in-memory cache mà không cài đặt cơ chế TTL (Time to Live) hay giới hạn số lượng phần tử.
Cơ chế overcommit của Linux và OOM Killer
Trên các môi trường Cloud Server hay VPS, hệ điều hành Linux sử dụng chiến lược cấp phát lạc quan (overcommit). Khi tiến trình gọi hàm malloc() để xin RAM, hệ điều hành lập tức gật đầu cho phép dù chưa thực sự gán các trang vật lý (physical pages) tương ứng. Kernel chỉ thực sự ánh xạ RAM vật lý khi tiến trình bắt đầu ghi dữ liệu lên vùng nhớ đó (cơ chế page fault).
Tuy nhiên, khi ứng dụng được deploy trên Docker hoặc Kubernetes, nó bị trói buộc bởi Linux cgroups (điển hình là chỉ số memory.max trong cgroup v2). Khi ứng dụng ghi dữ liệu, nếu tổng dung lượng chạm ngưỡng cgroup mà kernel không thể thu hồi thêm trang nào (reclaim thất bại), Linux OOM Killer sẽ lập tức kích hoạt.
OOM Killer giải quyết vấn đề bằng cách gửi tín hiệu cưỡng chế SIGKILL (Signal 9) đến tiến trình. Tiến trình bị hủy ngay lập tức, sinh ra mã thoát 128 + 9 = 137. Theo chuẩn POSIX, tiến trình không thể block (chặn) hay ignore (bỏ qua) tín hiệu SIGKILL. Do đó, mọi cơ chế xử lý lỗi hay ghi log trong code Rust của bạn đều vô tác dụng.
Cạm bẫy Page Cache và Kernel Memory trong cgroup v2
Một sai lầm phổ biến của các kỹ sư SRE/DevOps là nhầm tưởng rằng chỉ số memory.current trong cgroup v2 chỉ đếm lượng RAM do ứng dụng trực tiếp cấp phát (Anonymous memory/Heap). Thực tế, hệ thống đo lường của cgroup v2 khắt khe hơn rất nhiều:
- Page Cache: Bộ nhớ đệm sinh ra khi container sử dụng các lệnh đọc file hoặc
mmap. Thậm chí nếu bộ đệm này ở trạng thái clean và có thể giải phóng bất cứ lúc nào, hệ điều hành vẫn đếm nó vào tổng mức sử dụng RAM của pod. - Kernel Memory: Bao gồm kernel stacks, slab, socket buffers. Nếu ứng dụng Rust của bạn mở lượng lớn kết nối mạng (sockets) đồng thời hoặc chạy quá nhiều luồng (threads), phần RAM do kernel cấp phát để phục vụ các tài nguyên này sẽ bị cộng dồn, có thể phình to lên tới hàng trăm MB.
Khi tổng hợp cả Heap, Page Cache và Kernel Memory chạm mức memory.max, việc ứng dụng bị hệ thống trừng phạt là điều không thể tránh khỏi.
Tại sao lệnh Vec::push mặc định lại làm sập ứng dụng?
Khi không gian heap cạn kiệt, các cấu trúc dữ liệu chuẩn của Rust như Vec hay String khi xin cấp phát thêm RAM và nhận về kết quả thất bại sẽ tự động gọi hàm nội bộ handle_alloc_error. Theo thiết kế mặc định, hàm này sẽ gọi lệnh abort để dừng tiến trình ngay lập tức. Mục tiêu là bảo vệ tính toàn vẹn dữ liệu thay vì để ứng dụng chạy tiếp trong trạng thái bất định, nhưng hậu quả là toàn bộ web server của bạn sập hoàn toàn chỉ vì một request ngoại cỡ.
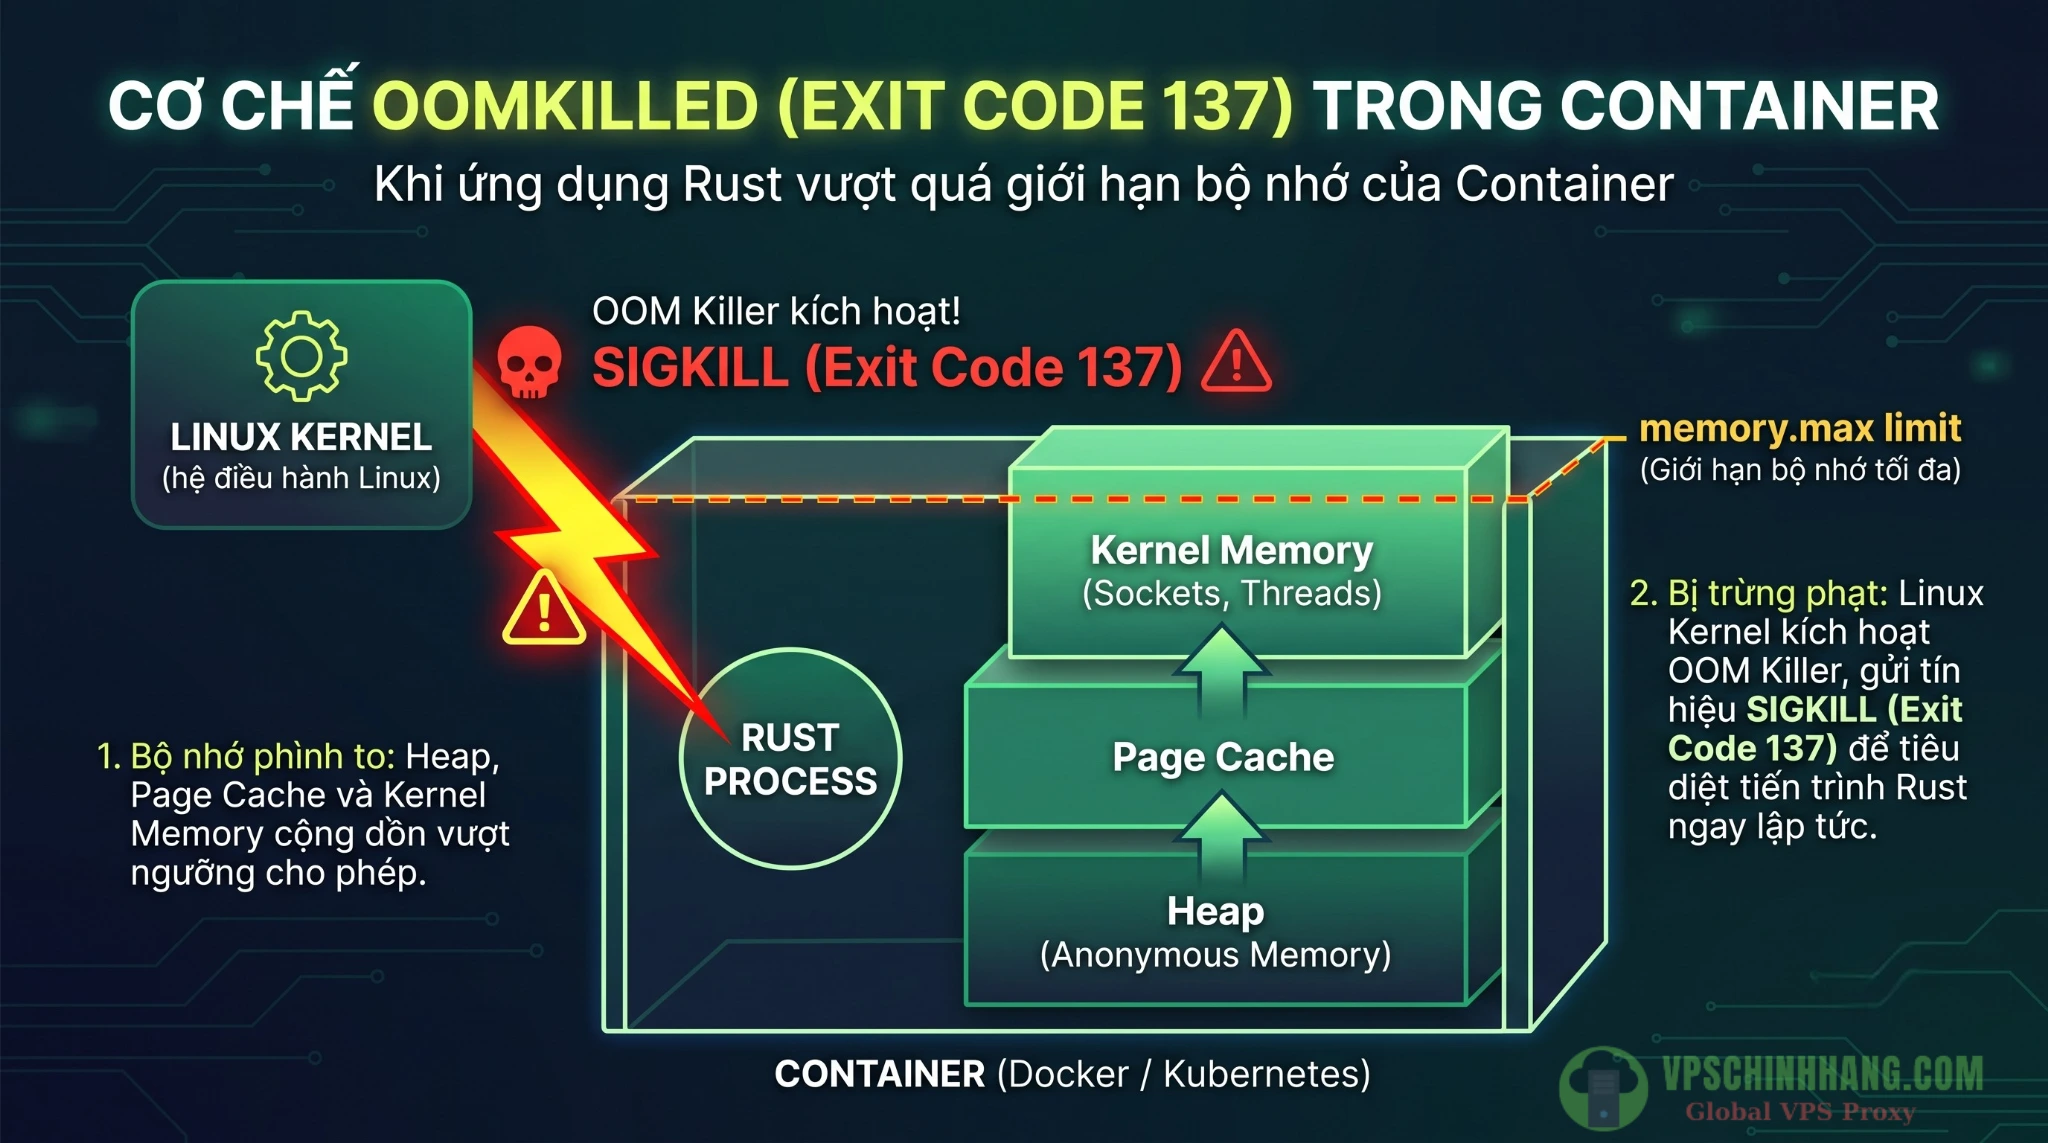
Cơ chế OOM Killer kích hoạt khi tổng tài nguyên RAM (bao gồm cả Heap, Page Cache và Kernel Memory) chạm ngưỡng giới hạn của cgroup v2.
Rust 1.100 có gì mới? Sức mạnh của trait Allocator đã ổn định
Một bước tiến mang tính chiến lược cho các kỹ sư backend là việc tính năng Allocator API chính thức được ổn định (stabilized) một phần cốt lõi trong phiên bản Rust 1.100. Bạn không còn cần phải sử dụng trình biên dịch Nightly hay bật cờ #![feature(allocator_api)] để sử dụng custom allocator cho các collection cơ bản như Vec hay Box.
Khác biệt giữa GlobalAlloc và Allocator API
Từ phiên bản Rust 1.28, ngôn ngữ đã cung cấp GlobalAlloc thông qua thuộc tính #[global_allocator]. Cơ chế này yêu cầu bạn định nghĩa một bộ cấp phát chung cho toàn bộ chương trình. Việc này mang lại hiệu quả khi đổi sang bộ cấp phát khác nhưng lại thiếu đi sự tinh tế nếu bạn muốn quản lý RAM riêng biệt cho từng khối logic, từng tenant hay từng request.
Với trait Allocator đã có mặt trên stable:
- Phân vùng linh hoạt: Bạn có thể truyền trực tiếp một allocator tùy chỉnh vào collection thông qua tham số generic. Ví dụ:
Vec<T, A: Allocator>hoặcBox<T, A: Allocator>. - Cơ chế Fallible (Xử lý lỗi êm ái): Các method của trait này trả về kiểu
Result<NonNull<[u8]>, AllocError>. Khi hệ thống hết bộ nhớ, nó trả về lỗi (Err) thay vì kích hoạtpanichayabort. Điều này cung cấp nền tảng vững chắc để xây dựng cơ chế Graceful Degradation (từ chối request một cách kiểm soát thay vì sập toàn hệ thống). - Quản lý vòng đời chi tiết: Cung cấp đầy đủ quyền điều khiển qua các hàm co giãn bộ nhớ như
grow,grow_zeroed,shrink.
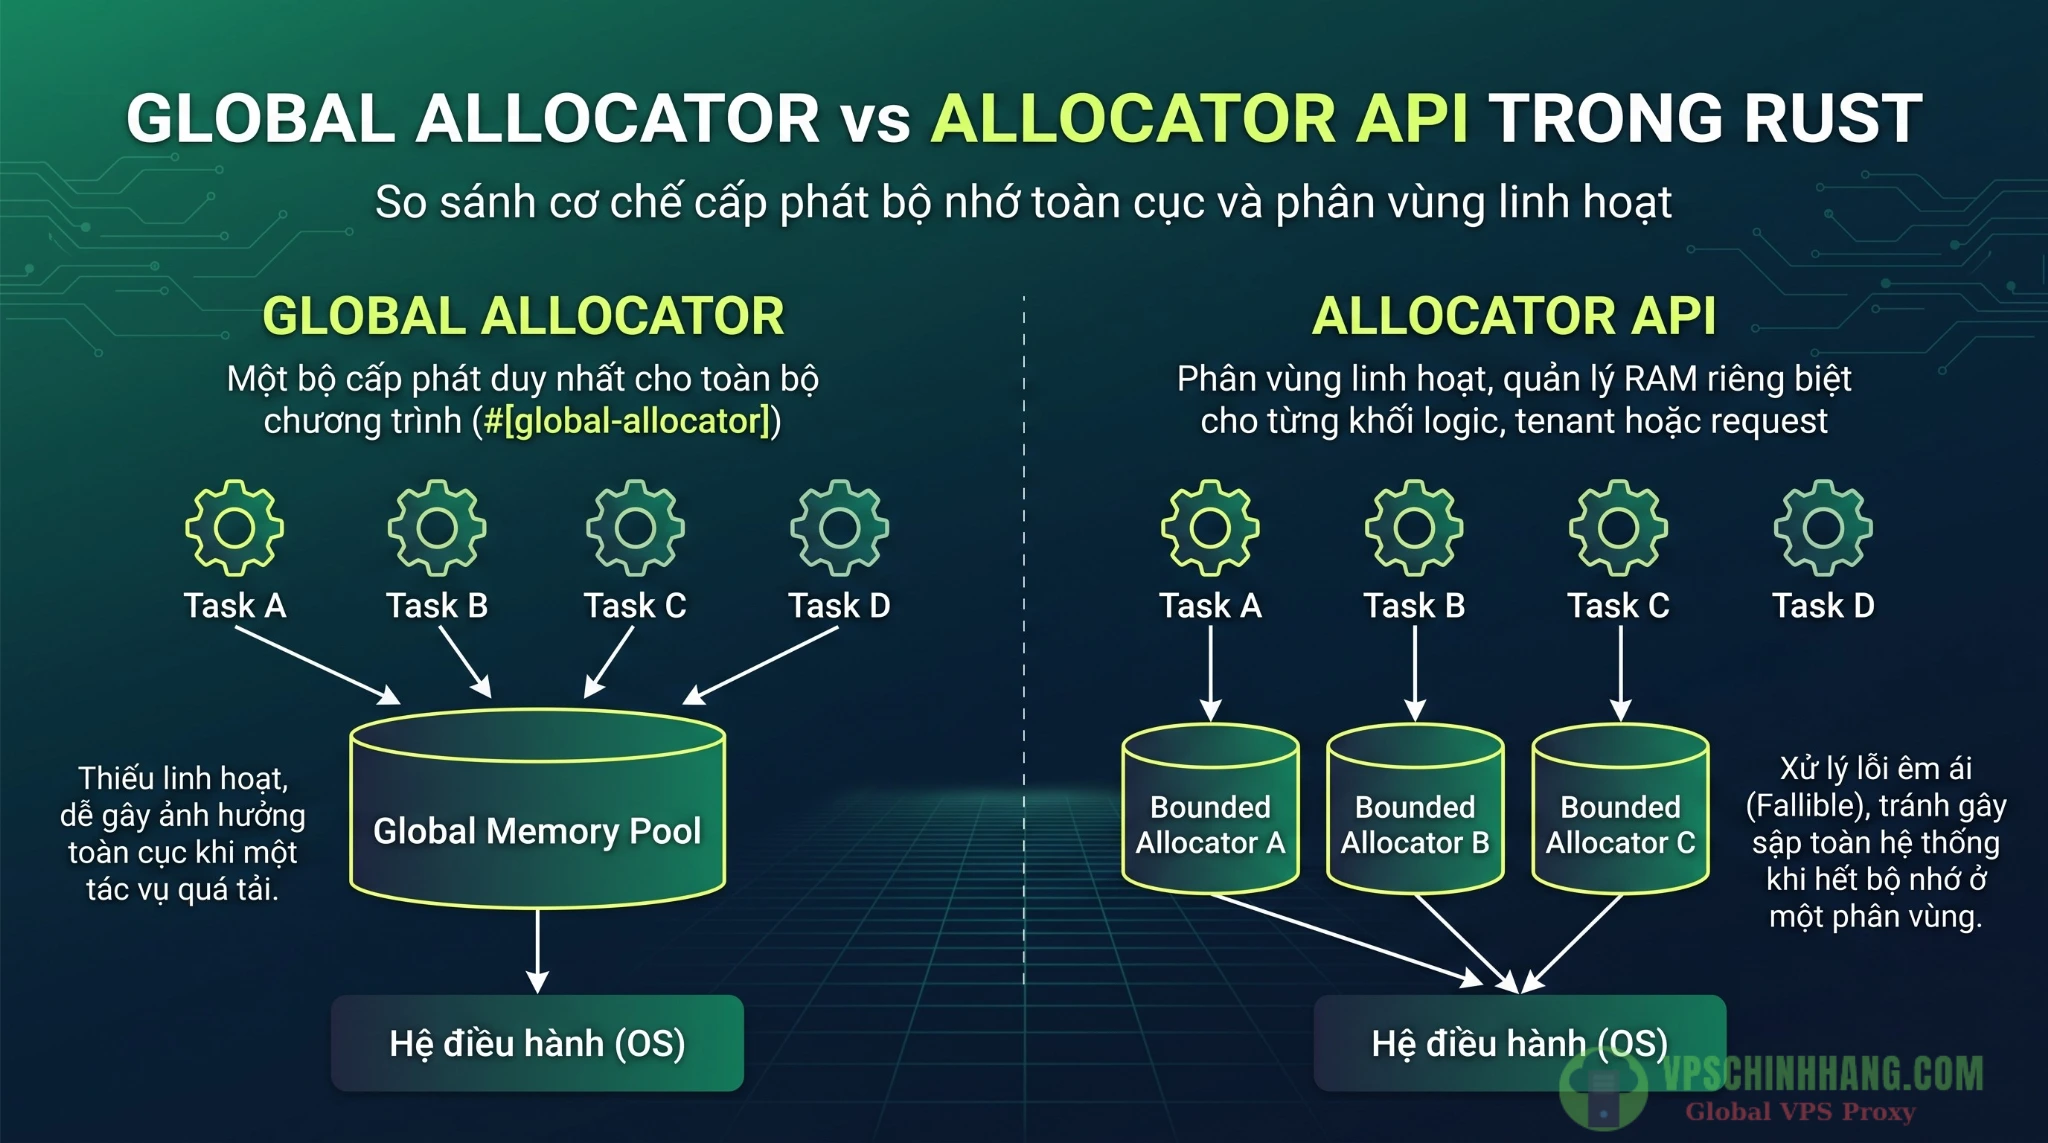
Sự khác biệt về kiến trúc quản lý RAM: Global Allocator dùng chung một luồng, trong khi Allocator API chia nhỏ vùng nhớ độc lập cho từng tiến trình.
Thực chiến tối ưu bộ nhớ Rust 1.100 Cloud Server qua 3 lớp bảo vệ
Để ứng phó với lỗi OOMKilled trên môi trường Cloud Server, kỹ sư backend cần xây dựng hệ thống phòng thủ nhiều lớp ngay bên trong mã nguồn. Việc tận dụng sức mạnh của phiên bản 1.100 sẽ giúp ứng dụng tự tin đứng vững trước các đợt tải đột biến.
Lớp 1: Bounded Allocator – Cấp hạn mức RAM cho từng job/tenant
Trong một hệ thống xử lý multi-tenant hoặc các background job phức tạp, một tiến trình chạy ngầm vô tình lặp vô hạn có thể nuốt trọn RAM của toàn bộ node. Giải pháp kỹ thuật lúc này là tạo ra một BoundedAllocator. Allocator này sẽ bọc bên ngoài allocator nền (Global), sử dụng biến đếm nguyên tử (AtomicUsize) để chặn đứng hành vi xin cấp phát nếu vượt qua ngân sách quy định.
Dưới đây là mã nguồn minh họa chạy trực tiếp trên Rust 1.100 stable:
use std::alloc::{AllocError, Allocator, Global, Layout};
use std::ptr::NonNull;
use std::sync::atomic::{AtomicUsize, Ordering};
use std::sync::Arc;

#[derive(Clone)]
pub struct BoundedAllocator<A: Allocator = Global> {
    inner: A,
    allocated: Arc<AtomicUsize>,
    max_bytes: usize,
}

impl<A: Allocator> BoundedAllocator<A> {
    pub fn new(max_bytes: usize, inner: A) -> Self {
        Self {
            inner,
            allocated: Arc::new(AtomicUsize::new(0)),
            max_bytes,
        }
    }
}

unsafe impl<A: Allocator> Allocator for BoundedAllocator<A> {
    fn allocate(&self, layout: Layout) -> Result<NonNull<[u8]>, AllocError> {
        let size = layout.size();
        let mut cur = self.allocated.load(Ordering::Relaxed);

        // Kiểm tra nguyên tử mức sử dụng RAM
        loop {
            if cur.saturating_add(size) > self.max_bytes {
                // Đạt trần ngân sách: Từ chối cấp phát
                return Err(AllocError);
            }

            match self.allocated.compare_exchange_weak(
                cur,
                cur + size,
                Ordering::SeqCst,
                Ordering::Relaxed,
            ) {
                Ok(_) => break,
                Err(actual) => cur = actual,
            }
        }

        match self.inner.allocate(layout) {
            Ok(non_null) => Ok(non_null),
            Err(e) => {
                // Rollback biến đếm nếu OS thực sự từ chối cấp phát
                self.allocated.fetch_sub(size, Ordering::SeqCst);
                Err(e)
            }
        }
    }

    unsafe fn deallocate(&self, ptr: NonNull<u8>, layout: Layout) {
        self.inner.deallocate(ptr, layout);
        self.allocated.fetch_sub(layout.size(), Ordering::SeqCst);
    }
}
Với cấu trúc này, bạn có thể khởi tạo một job với giới hạn rõ ràng: let mut job_data: Vec<u8, _> = Vec::new_in(BoundedAllocator::new(100 * 1024 * 1024, Global));. Background job này chỉ được phép dùng tối đa 100MB RAM, đảm bảo an toàn cho các tiến trình khác.
Lớp 2: Xử lý fallible allocation với try_reserve
Khi BoundedAllocator ở Lớp 1 chặn cấp phát, chúng ta phải hứng lỗi đó ở tầng nghiệp vụ. Thay vì dùng push() (gây abort khi lỗi), developer cần chuyển sang dùng try_reserve().
API này cho phép các web framework (như Axum) bắt ngoại lệ và phản hồi lại người dùng mã HTTP 503 (Service Unavailable), thực hiện cắt tải (Load Shedding) một cách êm ái.
use axum::{
    http::StatusCode,
    response::{IntoResponse, Response},
};
use std::collections::TryReserveError;

// Định nghĩa kiểu lỗi phản hồi cho Axum
pub struct OomError(TryReserveError);

impl IntoResponse for OomError {
    fn into_response(self) -> Response {
        (
            StatusCode::SERVICE_UNAVAILABLE,
            "Hệ thống đang chịu tải cao, tác vụ bị từ chối để bảo vệ máy chủ.",
        ).into_response()
    }
}

pub fn safe_append_chunk(buffer: &mut Vec<u8>, chunk: &[u8]) -> Result<(), OomError> {
    // Dự trữ RAM an toàn, hứng lỗi thay vì sập process
    buffer.try_reserve(chunk.len()).map_err(OomError)?;
    buffer.extend_from_slice(chunk);
    Ok(())
}
Khi nhận được HTTP 503, Load Balancer (Nginx/HAProxy) hoặc client có thể tự động retry hoặc route traffic sang node khác đang rảnh rỗi hơn.
Lớp 3: Request-scoped Arena để tránh phân mảnh (fragmentation)
Trong các endpoint phải bóc tách (parse) tập tin JSON, XML hoặc Protobuf phức tạp, ứng dụng sẽ thực hiện hàng chục nghìn thao tác cấp phát chuỗi nhỏ. Khi request kết thúc, các ô nhớ này được giải phóng, để lại vô vàn lỗ hổng li ti trong heap. Kernel Linux quản lý bộ nhớ theo trang (page, thường là 4KB). Nếu một trang 4KB có 99% không gian trống nhưng vẫn còn vướng 1 byte đang được dùng, kernel không thể thu hồi toàn bộ trang đó. Đây là bản chất của sự phân mảnh bộ nhớ (memory fragmentation).
Giải pháp kỹ thuật phổ biến là áp dụng mô hình Bump Allocator (Arena) thông qua các crate như bumpalo. Nó xin trước một mảng nhớ lớn liền kề từ OS và phân phối dần cho các tác vụ bên trong request.
use bumpalo::Bump;

pub fn handle_heavy_request(payload: &[u8]) {
    // Xin trước một khối RAM lớn (ví dụ 256KB) cho toàn bộ vòng đời Request
    let arena = Bump::with_capacity(256 * 1024);

    // Các thành phần được cấp phát liền kề, không tạo ra khoảng trống
    let field_name = arena.alloc_str("user_id");
    let field_val = arena.alloc_slice_copy(&payload[0..payload.len().min(32)]);

    let mut records = bumpalo::vec![in &arena; field_val];

    // Khi thoát khỏi hàm, `arena` bị drop.
    // Hệ thống trả toàn bộ khối 256KB về OS trong một thao tác O(1) duy nhất.
}
Kiến trúc Arena hạn chế đáng kể hiện tượng rò rỉ RAM rỉ rả, tối ưu hóa tốc độ CPU cache và giữ cho Resident Set Size (RSS) của tiến trình luôn ở mức ổn định.
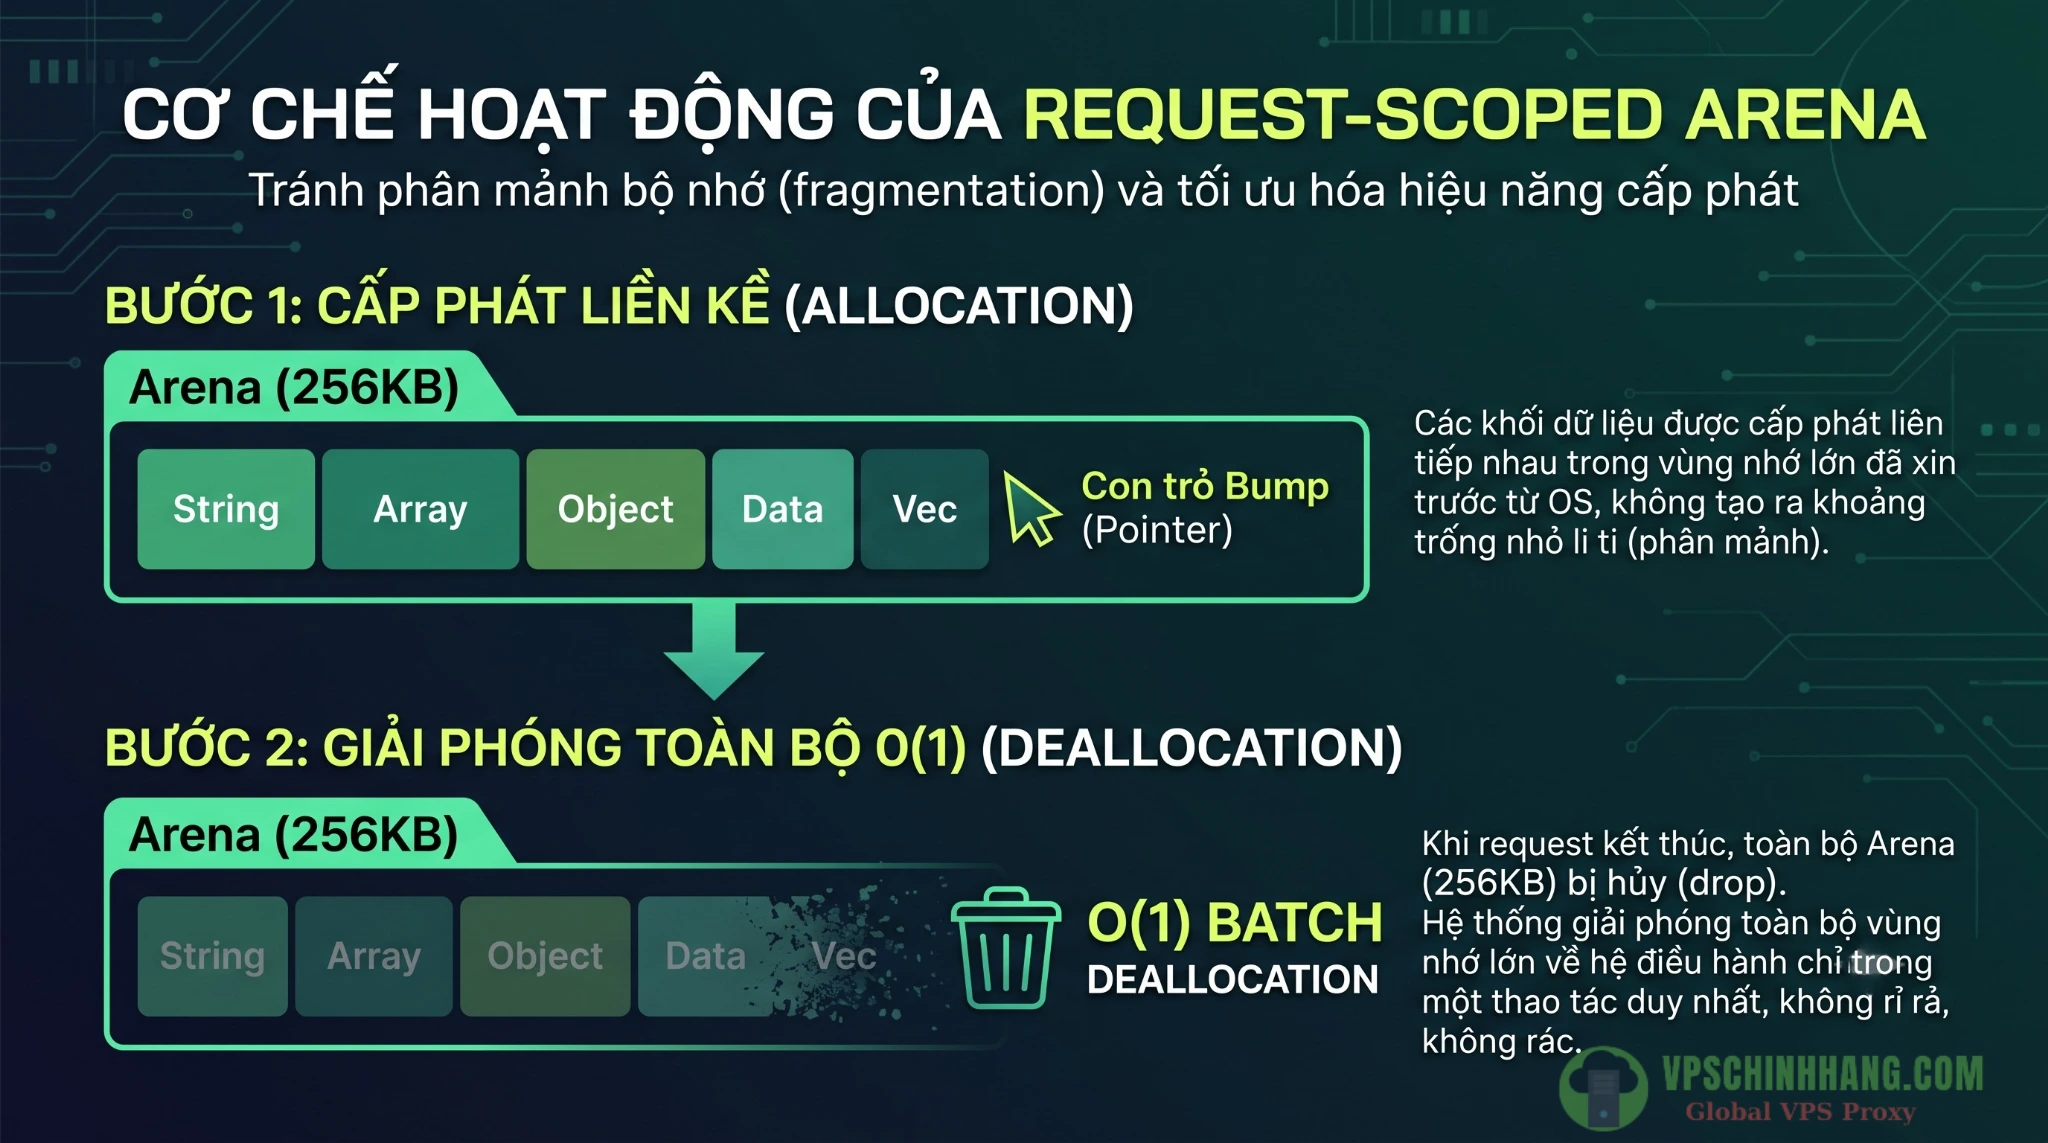
Bump Allocator cấp phát dữ liệu kề nhau liền mạch và giải phóng toàn bộ khối Arena khi request kết thúc, ngăn chặn triệt để sự phân mảnh RAM.
Kiểm soát đầu vào bằng Linux PSI & cgroup v2 memory.high
Các phương pháp can thiệp qua mã nguồn hoạt động rất hiệu quả, nhưng nếu traffic dội vào liên tục, ứng dụng vẫn cần một người gác đổng chặn lưu lượng ngay ở tầng mạng. Trước đây, nhiều hệ thống dùng Semaphore thủ công và tự tính toán RAM dựa trên file memory.max. Phương pháp này hiện bộc lộ nhiều điểm yếu vì không thể đo lường thực tế các loại overhead ẩn của kernel như Page Cache. Công nghệ hệ thống năm 2026 hướng tới việc sử dụng tính năng nội tại của hệ điều hành.
Lắng nghe áp lực RAM qua memory.pressure (Linux PSI)
Linux Pressure Stall Information (PSI) cung cấp số liệu thời gian thực về việc phần cứng đang bị tắc nghẽn ở tài nguyên nào (CPU, Memory, IO). Trong cgroup v2, bạn có thể đọc tệp /proc/pressure/memory hoặc /sys/fs/cgroup/memory.pressure.
Thay vì đoán dung lượng RAM còn lại, ứng dụng Rust có thể sử dụng crate như psi để lắng nghe các event some hoặc full. Nếu chỉ số average 10s (trung bình 10 giây) của áp lực bộ nhớ tăng vọt, điều đó có nghĩa là kernel đang phải vất vả dọn dẹp trang nhớ. Lúc này, ứng dụng Rust tự động chuyển sang chế độ Load Shedding: từ chối các request mới bằng HTTP 503 cho đến khi áp lực PSI giảm xuống mức an toàn.
Cấu hình memory.high để throttle thay vì kill
Bên cạnh memory.max (giới hạn cứng, hễ chạm là bị OOMKilled), cgroup v2 cung cấp một chỉ số linh hoạt hơn: memory.high.
memory.high đóng vai trò là một giới hạn mềm (throttle limit). Khi lượng RAM của container chạm mức này, tiến trình không bị kill. Thay vào đó, Linux kernel sẽ bóp băng thông (throttle) các tiến trình trong cgroup, cố tình làm chậm việc thực thi mã để ép chúng nhả lại tài nguyên và ngăn chặn đà tăng trưởng RAM.
Trong file triển khai Kubernetes (Pod Spec) hoặc systemd, bạn có thể thiết lập:
- Giới hạn
memory.highở mức 80-85% so với giới hạn vật lý. - Thiết lập hệ thống cảnh báo Prometheus khi xuất hiện tín hiệu throttle để developer có thời gian can thiệp trước khi sự cố xảy ra.
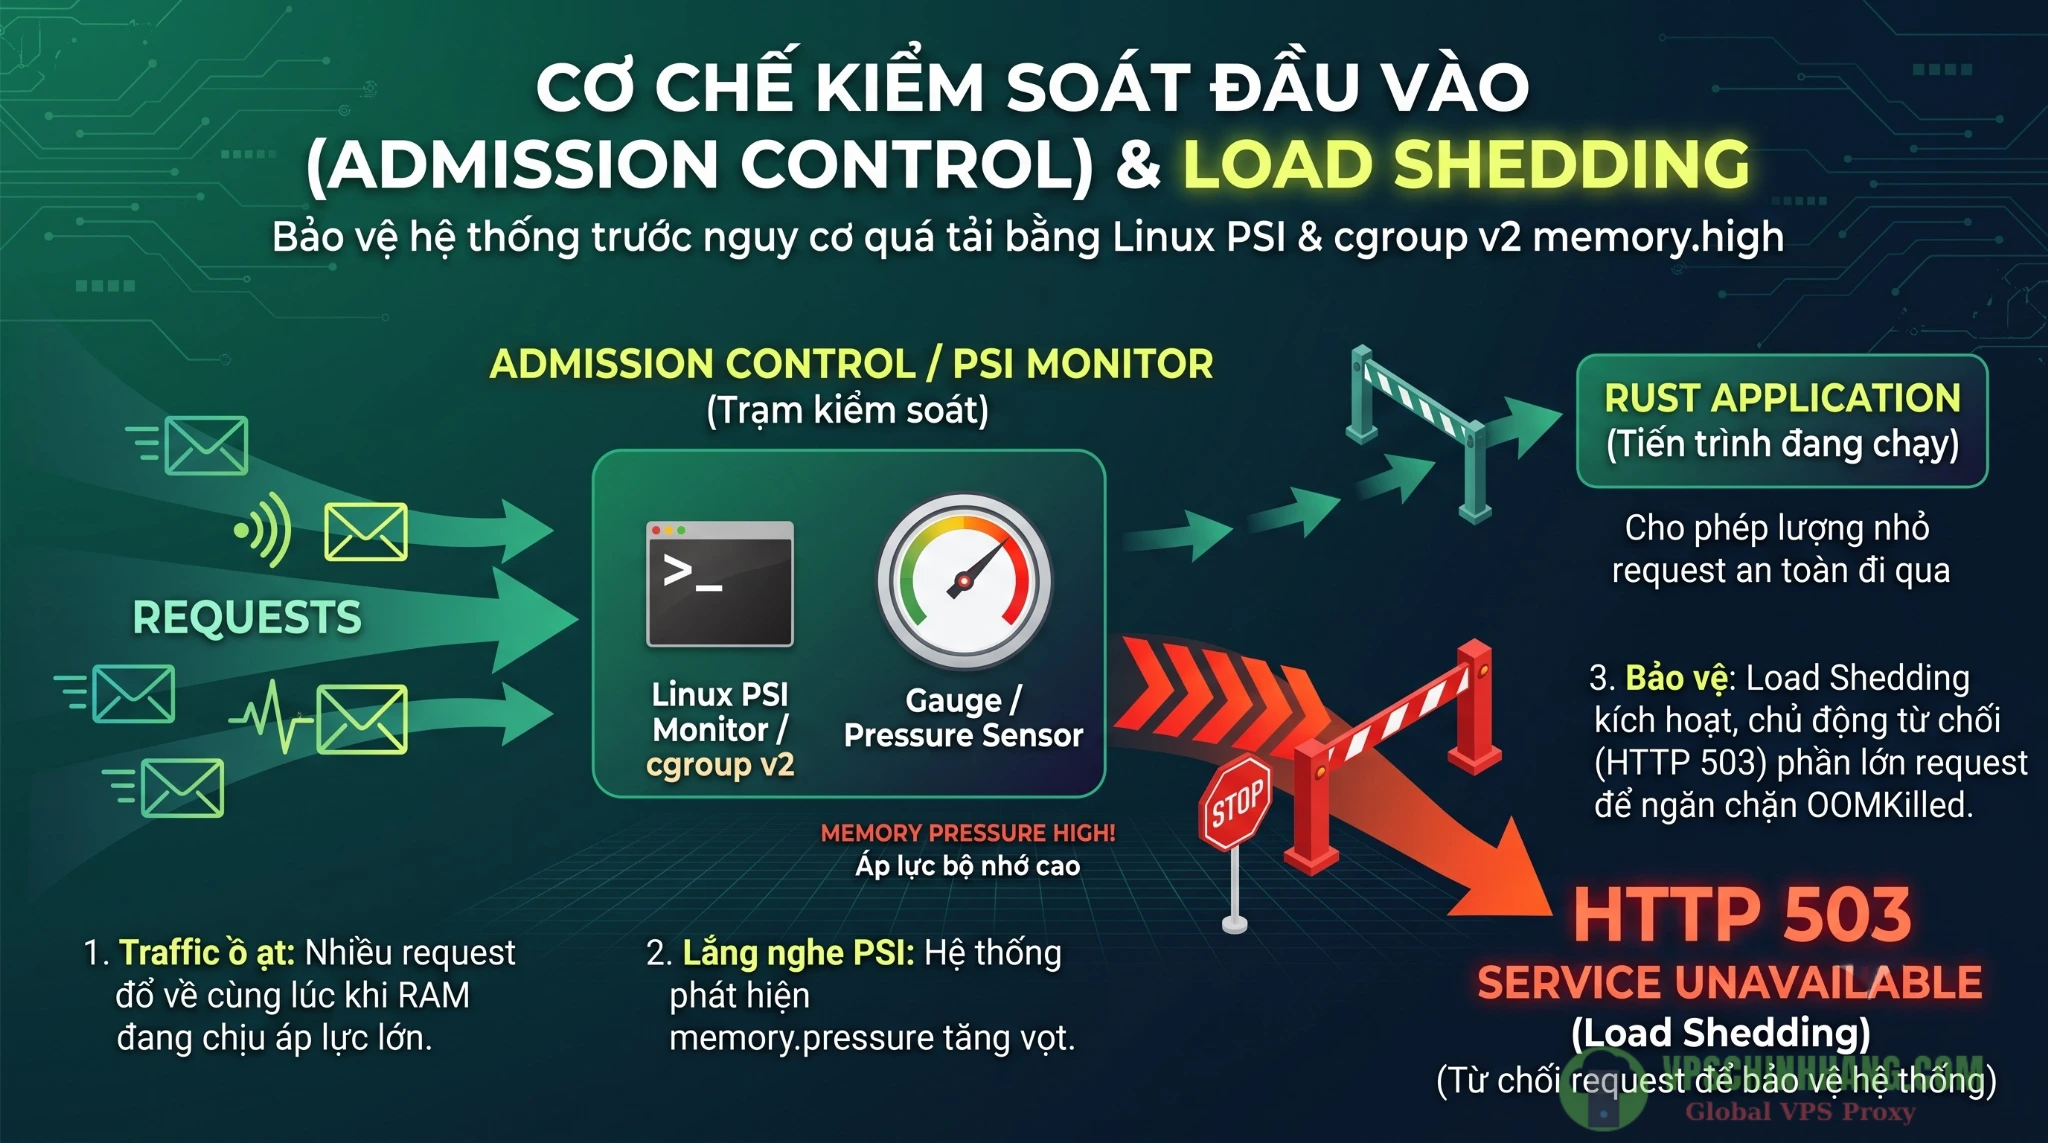
Hệ thống tự động cắt tải (Load Shedding) và trả về HTTP 503 ngay tại cửa ngõ khi chỉ số áp lực bộ nhớ (Linux PSI) tăng cao.
Global Allocator: Tạm biệt jemalloc, chào đón mimalloc và auto-allocator
Ở cấp độ toàn cục (Global Allocator), allocator mặc định của Linux là glibc malloc thường bộc lộ điểm yếu khi chạy trên các web framework bất đồng bộ (như Tokio) với số lượng luồng lớn. Việc liên tục chuyển giao các vùng nhớ giữa các worker thread tạo ra sự phân tán bộ nhớ trống rải rác trên nhiều arena, khiến hệ điều hành gặp khó khăn trong việc thu hồi RAM.
Mặc dù cộng đồng từng xem jemalloc là tiêu chuẩn cho backend Rust, dự án này hiện đã bước vào giai đoạn ngừng phát triển (deprecate). Các kỹ sư SRE và DevOps hiện đại đang dịch chuyển sang các giải pháp tối ưu và linh hoạt hơn.
Đặc điểm nổi bật của mimalloc & tối ưu độ trễ P99
Được phát triển bởi Microsoft Research, mimalloc nổi bật với khả năng giảm phân mảnh đáng kể nhờ cơ chế phân tán danh sách trống (free list sharding) và làm rỗng trang (eager page purging).
Tuy nhiên, đối với một backend server chịu tải nặng, giá trị quan trọng của việc đổi allocator không chỉ nằm ở việc tiết kiệm RAM, mà là ở việc tối ưu Tail Latency (Độ trễ P99/P95). Trong các hệ thống lớn, việc tối ưu allocator thường không làm giảm độ trễ trung bình (P50), nhưng nó thể hiện hiệu năng ở những request tiêu tốn nhiều tài nguyên (heavy requests). Việc mimalloc sử dụng Thread-local caches chuyên biệt giúp các luồng (threads) không bị block lẫn nhau khi đồng loạt xin cấp phát bộ nhớ. Nhờ loại bỏ hiện tượng Global Lock contention, chỉ số P99 luôn được duy trì ổn định, tránh các đợt giật lag (latency spikes) không đáng có.
Đơn giản hóa với auto-allocator
Để tối ưu thời gian tích hợp, thay vì phải đắn đo lựa chọn và cấu hình môi trường phức tạp, bạn có thể sử dụng crate auto-allocator. Thư viện này có khả năng tự động nhận diện kiến trúc hệ điều hành và phần cứng bên dưới, sau đó tiêm (inject) allocator phù hợp (thường là mimalloc trên hệ thống Linux/Windows) chỉ với một dòng khai báo:
# Cargo.toml
[dependencies]
auto-allocator = "0.1"
// main.rs
use auto-allocator::AutoAllocator;

#[global_allocator]
static GLOBAL: AutoAllocator = AutoAllocator;
Việc thay thế Global Allocator bằng các thư viện hiện đại là bước mang lại hiệu quả quick win rõ rệt. Bạn sẽ thấy biểu đồ RSS của ứng dụng đi ngang ổn định thay vì có xu hướng tăng dần đều theo thời gian.
Checklist vận hành lên production cho backend developer
Quá trình tối ưu bộ nhớ Rust 1.100 Cloud Server là một chuỗi các tinh chỉnh đồng bộ từ hệ điều hành xuống đến cấp độ mã nguồn. Trước khi merge Pull Request và đẩy code lên môi trường production, hãy rà soát kỹ các hạng mục sau:
- Chặn lưu lượng thông minh (Proactive Admission Control): Tích hợp đọc chỉ số Linux PSI (
memory.pressure) hoặc cấu hìnhmemory.highở mức 85%. Chủ động trả về HTTP 503 khi server có dấu hiệu đuối sức thay vì cố gắng ôm đồm và rơi vào bẫy OOMKilled. - Loại bỏ các API Panic ngầm: Quét toàn bộ codebase, thay thế các thao tác cấp phát lượng lớn dữ liệu bằng
Vec::pushsang APItry_reserve(). Hướng dẫn framework xử lý lỗi bằng cơ chế Graceful Degradation. - Bọc Allocator cho Job nặng: Tận dụng tính năng ổn định của trait
Allocatortrong Rust 1.100 để giới hạn ngân sách RAM cho các batch job, tenant thông quaBoundedAllocator. - Khử phân mảnh bằng Arena: Sử dụng
bumpalocho các đoạn logic yêu cầu parse JSON/Protobuf dung lượng lớn. Trả RAM về OS trong một nhịp (O(1)) khi kết thúc request. - Cập nhật Global Allocator: Gỡ bỏ các thư viện cũ đã ngừng phát triển, áp dụng
mimallochoặcauto-allocatorđể tối ưu cơ chế thu hồi trang nhớ. Đừng quên kết hợp công cụ giám sát hệ thống như Prometheus để theo dõi sát sao biểu đồ RSS và giữ vững chỉ số P99 Tail Latency. - Kiểm thử thực tế (Load Testing): Đặt cấu hình cgroup giới hạn bộ nhớ hẹp (ví dụ 512MB) và bơm traffic cường độ cao. Một hệ thống vận hành trơn tru là hệ thống phản hồi 503 ổn định khi quá tải, không xuất hiện dòng log
Exit code 137.
Câu hỏi thường gặp (FAQ)
1. Tính năng Allocator API trong Rust 1.100 đã an toàn để dùng trên production chưa?
Đã có thể sử dụng. Các thành phần cốt lõi như trait Allocator, Vec::new_in, và Box::new_in đã chính thức ổn định (stable) trên bản 1.100. Các API mở rộng khác vẫn đang chờ hoàn thiện ở các phiên bản sau.
2. Làm sao để phân biệt ứng dụng Rust bị crash do logic code hay do OOMKilled?
Hãy kiểm tra system log (dmesg -T | grep -i oom) hoặc chạy kubectl describe pod <pod-name>. Nếu thấy mã Exit code 137 và thông báo OOMKilled, tiến trình của bạn đã bị Linux cgroup tiêu diệt do vi phạm giới hạn RAM.
3. Đổi sang mimalloc hoặc auto-allocator có thực sự làm giảm dung lượng RAM tiêu thụ không?
Có giảm, nhưng giá trị cốt lõi nằm ở việc chống phân mảnh (fragmentation) và giảm độ trễ (latency). mimalloc giúp trả RAM thừa về cho hệ điều hành nhanh hơn và tránh tình trạng các luồng (threads) tranh chấp khóa (lock) khi xin bộ nhớ, giúp chỉ số P99 luôn ổn định.
4. Tôi có cần viết BoundedAllocator cho mọi ứng dụng Rust của mình không?
Không cần thiết. Chỉ nên áp dụng cho các hệ thống chia sẻ tài nguyên (multi-tenant), các API cho phép user upload file lớn, hoặc các background job xử lý dữ liệu phức tạp dễ gây phình RAM đột biến.
5. Giám sát bằng Linux PSI khác gì với việc đo RAM bằng Prometheus hay cAdvisor?
Prometheus/cAdvisor đo lường dung lượng RAM đã dùng theo chu kỳ (polling), dễ bỏ lỡ các đợt spike chớp nhoáng. Trong khi đó, Linux PSI đo lường áp lực phần cứng (độ trễ) theo thời gian thực, giúp ứng dụng nhận biết máy chủ đang quá tải để chủ động cắt tải (Load Shedding) ngay lập tức.
Kết luận
Kiểm soát bộ nhớ trong Rust không chỉ dừng lại ở việc mượn và trả (borrow checker). Việc ứng dụng chủ động từ chối request, cắt tải kịp thời không phải là tín hiệu của một hệ thống yếu kém. Trái lại, đó là đặc điểm của một kiến trúc phần mềm có độ tin cậy cao, biết cách tự bảo vệ mình trong những môi trường khắc nghiệt. Hãy áp dụng hiệu quả những cải tiến công nghệ mới để xây dựng các máy chủ vững chãi, đảm bảo hệ thống luôn sẵn sàng phục vụ người dùng 24/7.
Tài liệu tham khảo