

Hướng dẫn thiết lập Forward Proxy thu thập dữ liệu E-commerce phân tán & minh bạch
Bạn đã cẩn thận cấu hình DOWNLOAD_DELAY = 2.0, đã bật cờ ROBOTSTXT_OBEY trong framework, thậm chí cấp phát hẳn một dải IP hoàn toàn mới, nhưng hệ thống vẫn nhận về hàng loạt mã lỗi HTTP 429 Too Many Requests chỉ sau vài phút khởi chạy?
Nhiều developer và kỹ sư dữ liệu thường lầm tưởng rằng lỗi này xuất phát từ việc thiếu IP, dẫn đến việc liên tục tìm cách mở rộng danh sách Proxy để bù đắp. Tuy nhiên, nguyên nhân cốt lõi lại nằm ở kiến trúc điều phối mạng của toàn hệ thống. Việc hàng chục worker cùng lúc đẩy request qua một bộ định tuyến NAT chung, hoặc dồn dập retry khi gặp lỗi mạng, sẽ tạo ra các đỉnh tải (burst request) phá vỡ hoàn toàn giới hạn an toàn của máy chủ đích.
Việc thiết lập Forward Proxy thu thập dữ liệu theo kiến trúc phân tán chính là lời giải cho bài toán này, nhưng chỉ khi nó được đi kèm với một bộ não điều phối tập trung. Đâu là ranh giới giữa một luồng dữ liệu bền vững, tôn trọng hệ thống đích và một crawler bị đánh dấu là spam bot? Nếu developer từng đau đầu tìm hiểu nguyên nhân hệ thống thu thập dữ liệu bị block IP, hãy cùng bóc tách vấn đề và nâng cấp hạ tầng mạng của bạn ngay trong bài viết kỹ thuật chuyên sâu này.
Giải mã nỗi ám ảnh Rate-Limit: Tại sao đổi IP vẫn bị block oan?
Khi scale một hệ thống thu thập dữ liệu thị trường thương mại điện tử, rào cản kỹ thuật lớn thường gặp không phải là logic parse HTML, mà là cơ chế Rate Limiting từ các Web Application Firewall (WAF) hoặc API Gateway. Việc hiểu sai về Rate Limit sẽ khiến mọi nỗ lực xoay IP trở nên vô nghĩa.
Sự khác biệt giữa delay cục bộ và giới hạn đồng thời (Concurrency)
Nhiều kỹ sư cấu hình thời gian nghỉ (delay) trên từng luồng (thread) hoặc từng worker độc lập. Tuy nhiên, delay chỉ kiểm soát khoảng cách thời gian giữa hai yêu cầu nối tiếp nhau trên cùng một tiến trình. Nếu bạn có 50 worker chạy phân tán song song, tổng số kết nối mở đồng thời (concurrent requests) sẽ đổ dồn lên máy chủ đích cùng một thời điểm. Dù mỗi worker tuân thủ việc nghỉ 2 giây, máy chủ đích vẫn phải hứng chịu 50 request/giây. Khi trạm kiểm soát của trang e-commerce sử dụng thuật toán cửa sổ trượt (Sliding-window) để đếm hạn ngạch, cụm crawler của bạn sẽ nhanh chóng làm cạn kiệt token cho phép, dẫn đến mã lỗi 429 bật lên hàng loạt.
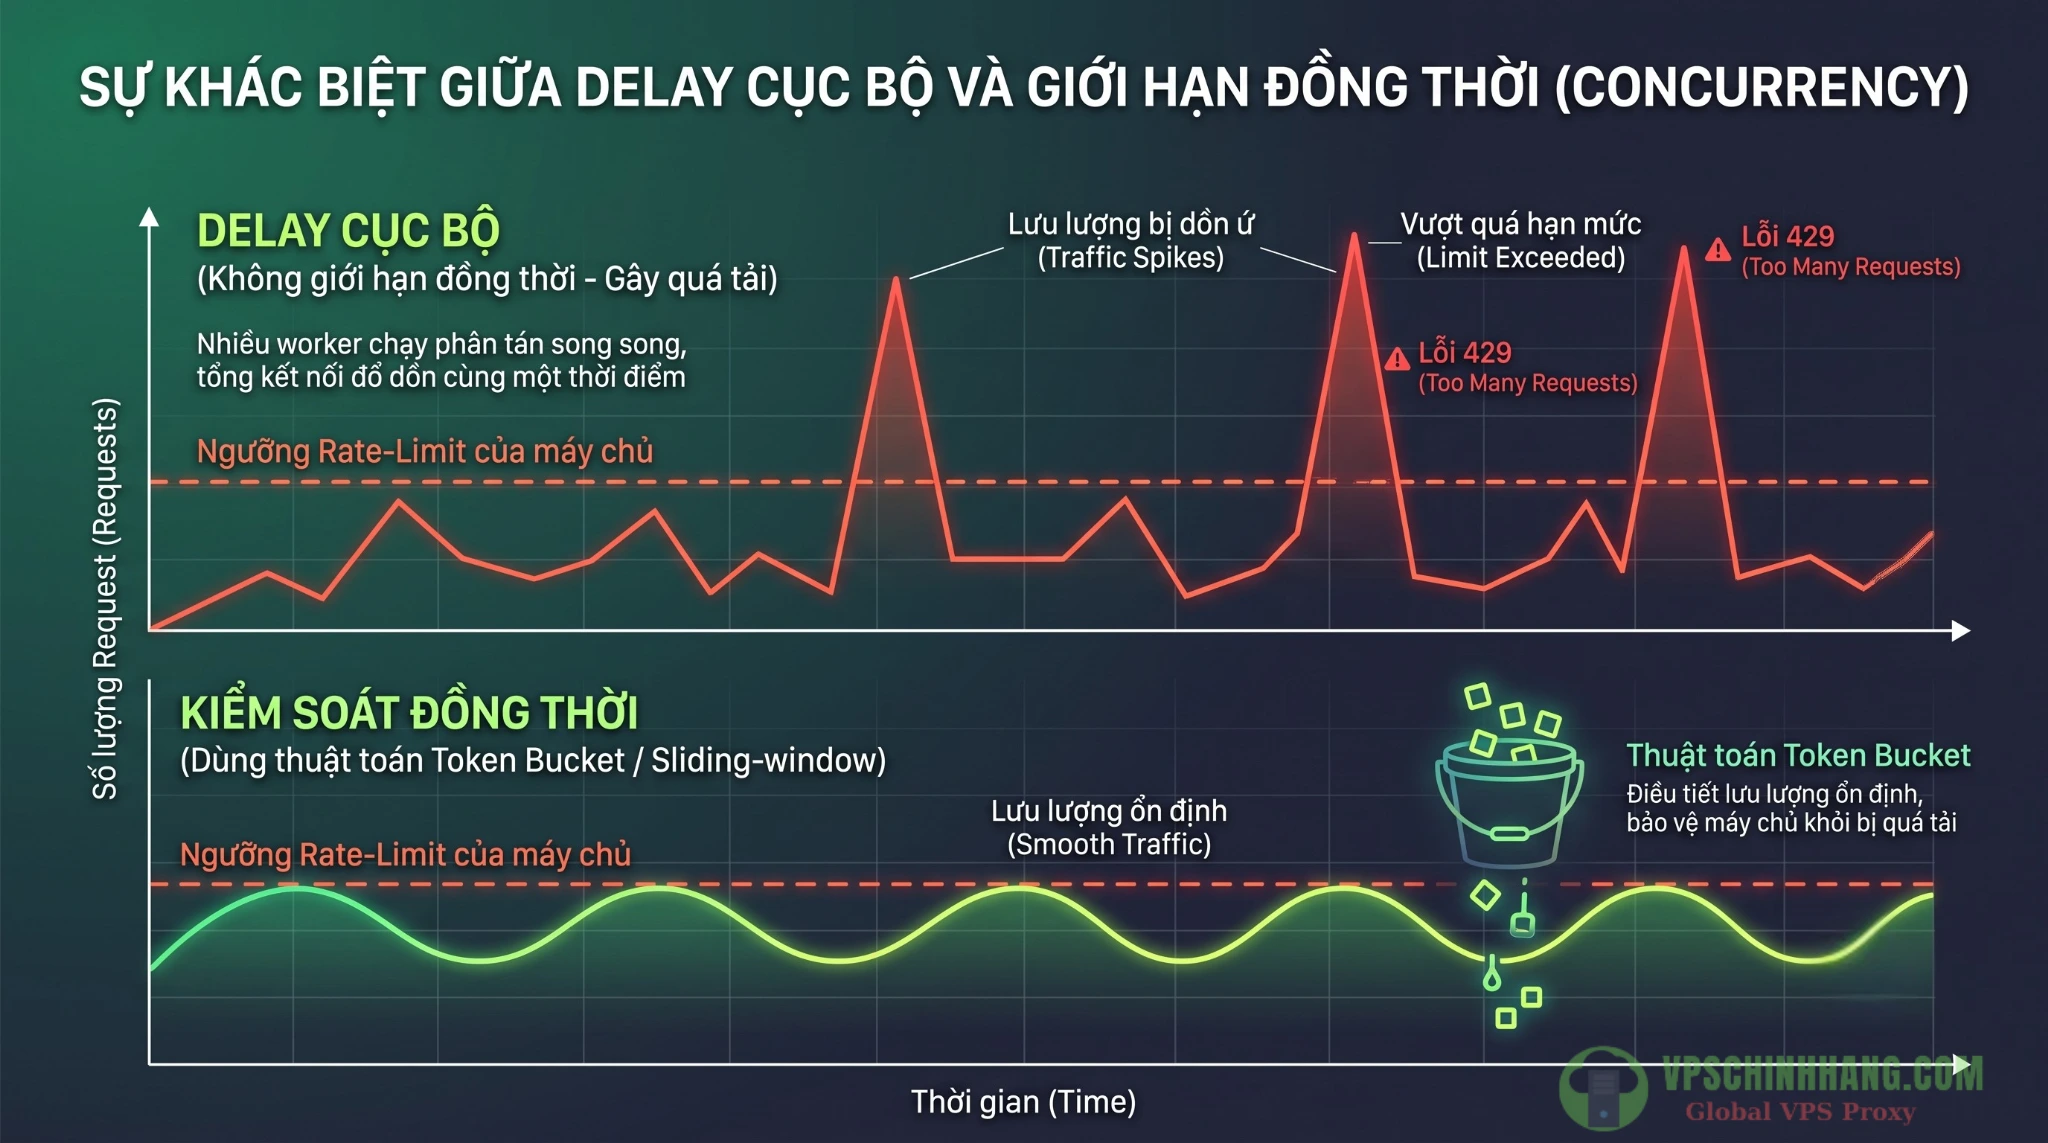
Minh họa sự khác biệt giữa lưu lượng bị burst request gây quá tải và lưu lượng được dàn đều qua thuật toán Token Bucket.
Ranh giới: Phân tán tải hợp lệ và quản lý kết nối
Trong quy hoạch hạ tầng dữ liệu, developer cần phân định rạch ròi hai tư duy sử dụng Proxy:
- Phân tán tải hợp lệ (Load Distribution): Sử dụng nhiều IP để chia sẻ lưu lượng, tránh nghẽn mạng cục bộ (bottleneck), tối ưu hóa băng thông outbound và duy trì kết nối ổn định. Danh tính máy khách (User-Agent) được khai báo rõ ràng. Quan trọng hơn cả: Nếu máy chủ báo quá tải (mã 429), toàn bộ hệ thống sẽ chủ động giảm tốc độ.
- Quản lý kết nối thiếu kiểm soát: Việc luân chuyển IP liên tục ngay khi gặp lỗi 429 hoặc 403 mà không tôn trọng thời gian chờ (backoff) sẽ tạo ra các đỉnh tải bất thường. Hành vi này vi phạm nguyên tắc giao tiếp minh bạch của Internet, dễ làm hệ thống đích kiệt quệ tài nguyên và dẫn đến rủi ro bị từ chối phục vụ đối với toàn bộ dải mạng.
Kiến trúc 3 lớp chống chặn oan cho hệ thống crawl phân tán
Để xây dựng một luồng lưu lượng chuẩn mực, hệ thống không nên để từng worker tự quyết định việc sử dụng IP hay thời điểm phát request. Kiến trúc đề xuất cho các team Data Engineering quy mô lớn sẽ bao gồm 3 lớp chuyên biệt:
- Lớp Crawler Workers (Thực thi): Bao gồm các tiến trình (viết bằng Python, Node.js, Rust) làm nhiệm vụ gọi mạng và parse dữ liệu (HTML/JSON). Lớp này hoạt động ở dạng phi trạng thái (stateless), có thể scale ngang linh hoạt trên Kubernetes hoặc Docker Swarm.
- Lớp Egress Policy Controller (Điều phối trung tâm): Đóng vai trò là bộ não. Nó kiểm tra file
robots.txt, quản lý hạn mức tốc độ (quota) trên toàn cụm (thường thông qua Redis), và quyết định lúc nào nên ngắt mạch (Circuit Breaker) khi gặp sự cố từ target site. - Lớp Forward Proxy Gateway (Vận chuyển): Bao gồm các node chuyển tiếp vật lý (Squid/HAProxy) hoặc các Gateway API từ nhà cung cấp Proxy. Lớp này nhận lệnh từ bộ điều phối, kết nối ra Internet bằng IP đầu ra hợp lệ, giúp ẩn đi IP nội bộ của cụm worker nhưng vẫn giữ tính minh bạch với website đích.
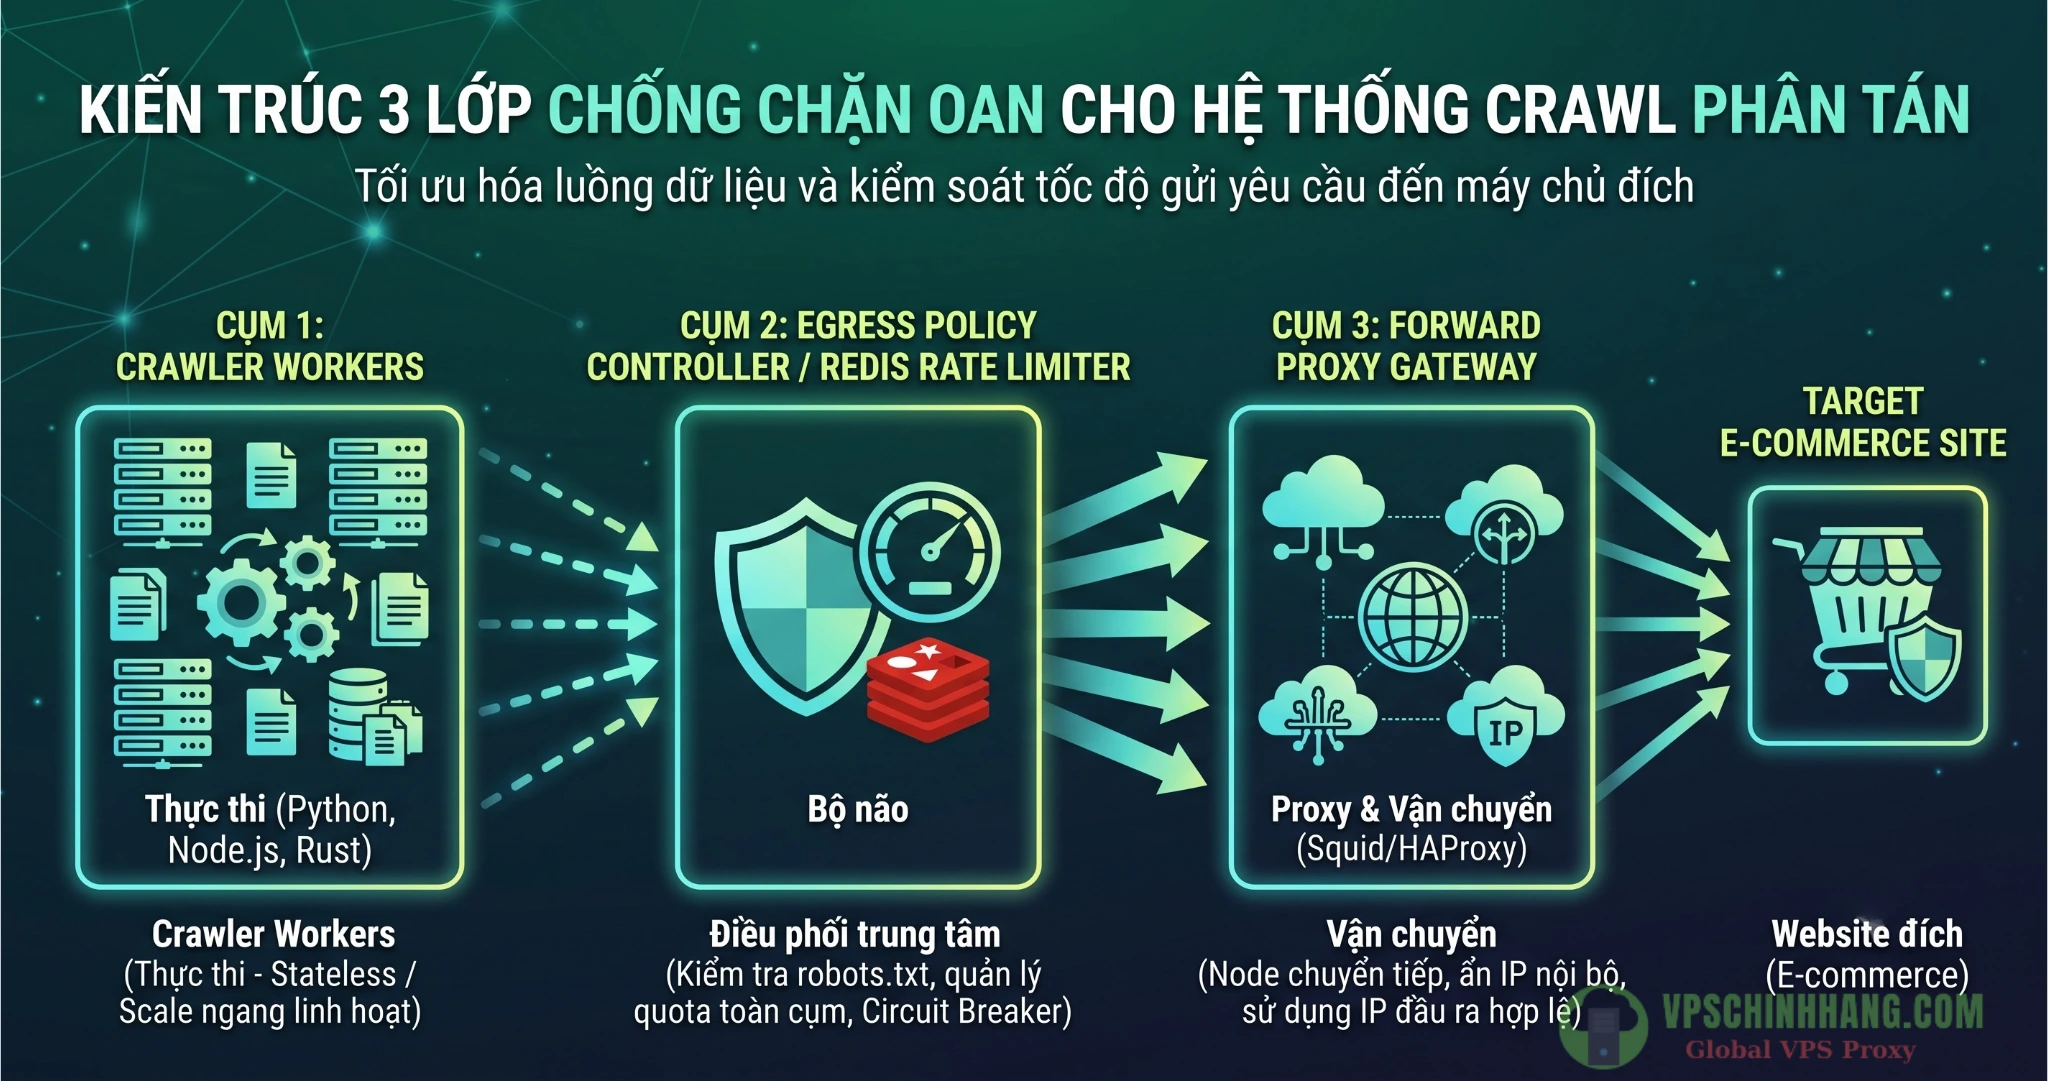
Kiến trúc 3 lớp tiêu chuẩn giúp cô lập logic xử lý mạng và điều phối giới hạn tốc độ tập trung.
4 bước thiết lập Forward Proxy thu thập dữ liệu bằng Squid (tự quản trị)
Với các doanh nghiệp có đội ngũ hạ tầng mạnh và muốn tự host luồng Proxy nội bộ nhằm kiểm soát 100% dữ liệu, Squid là một phần mềm proxy caching mang lại hiệu suất cao. Tuy nhiên, nếu cấu hình sai, bạn có thể vô tình tạo ra một Open Proxy, mở cửa cho các cuộc tấn công DDoS mượn đường.
Bước 1: Giới hạn socket binding trên mạng nội bộ (VPC/WireGuard)
Tuyệt đối không cấu hình tiến trình proxy lắng nghe trên giao diện mạng công khai (0.0.0.0). Tương tự như nguyên tắc cấu hình Egress Proxy trên VPS Linux để quản lý luồng request API an toàn, bạn cần bind (ràng buộc) cổng của Squid trực tiếp vào IP nội bộ của giao diện VPN (WireGuard) hoặc dải mạng VPC ảo.
# /etc/squid/squid.conf
# CHỈ lắng nghe trên IP cục bộ của mạng VPC hoặc WireGuard gateway
http_port 10.20.0.21:3128
# Không bao giờ sử dụng: http_port 3128 hoặc http_port 0.0.0.0:3128
Bước 2: Cấu hình ACL bảo mật theo nguyên tắc Deny-by-default
Áp dụng Access Control Lists (ACLs) nghiêm ngặt nhằm khống chế dải IP nguồn, chỉ cho phép worker từ subnet đã định danh đi qua proxy và chặn các phương thức lợi dụng mạng (như SSRF).
# 1. Định nghĩa dải mạng nội bộ an toàn (VPC subnet)
acl crawler_net src 10.20.0.0/16

# 2. Định nghĩa các cổng an toàn
acl Safe_ports port 80 443
acl SSL_ports port 443
acl CONNECT method CONNECT

# 3. Chặn lưu lượng truy cập cổng lạ và bảo vệ máy chủ nội bộ
http_access deny !Safe_ports
http_access deny CONNECT !SSL_ports
http_access deny to_localhost

# 4. Cho phép worker nội bộ và đóng toàn bộ cửa rào lại (Quy tắc sinh tử: Deny All ở cuối)
http_access allow crawler_net
http_access deny all

# 5. Xóa các header làm lộ IP nội bộ để bảo mật kiến trúc topology
forwarded_for delete
via off
Bước 3: Cấu trúc chiến lược luân chuyển IP (Proxy Rotation)
Thay vì đổi IP liên tục một cách máy móc, bộ điều phối cần cấp phát IP dựa trên đặc điểm của phiên (session):
- Per-request (Luân chuyển theo từng yêu cầu): Tối ưu cho việc scrape dữ liệu danh mục sản phẩm hoặc rà soát giá công khai, không yêu cầu trạng thái đăng nhập. Mỗi request lấy một node ngẫu nhiên để dàn đều tải trên toàn dải IP.
- Sticky Session (Cố định IP theo phiên): Bắt buộc sử dụng khi luồng dữ liệu đi qua giỏ hàng, điền form hoặc có token xác thực theo địa chỉ IP. Việc giữ nguyên IP trong 15-30 phút giúp hành vi truy cập trở nên logic, không bị hệ thống WAF chặn do dịch chuyển tọa độ địa lý quá nhanh.
Bước 4: Tự động quản lý health check bằng Redis
Đối với kiến trúc tự host (ví dụ khi team developer tự build Proxy Socks5 private trên VPS để bảo mật dữ liệu), bạn có thể sử dụng cấu trúc dữ liệu Sorted Set của Redis để chấm điểm (scoring) từng node proxy. Nếu một proxy liên tục trả về mã 502 (Bad Gateway) hoặc Timeout, điểm uy tín của nó sẽ bị trừ. Những IP rớt xuống dưới ngưỡng cho phép sẽ bị cô lập (quarantine) tự động để bảo trì, đảm bảo các worker luôn được cấp phát đường truyền ổn định.
Nghệ thuật giãn cách (Throttling): Tôn trọng hệ thống đích
Có IP tốt mới chỉ là điều kiện cần. Điều kiện đủ để hệ thống chạy mượt mà nhiều tháng liền là một bộ não điều phối lưu lượng thông minh.
Xây dựng global Rate Limiter bằng Redis Lua Script
Để khống chế tổng request/giây trên toàn bộ hàng chục worker, kỹ thuật tiêu chuẩn là áp dụng thuật toán Token Bucket xử lý bằng Lua Script bên trong Redis. Nhờ cơ chế thực thi nguyên tử (atomic execution), Lua Script loại bỏ triệt để hiện tượng tranh chấp dữ liệu (race condition) khi nhiều worker yêu cầu gửi request cùng một phần nghìn giây.
Thay vì mỗi worker tự đếm số request của riêng mình, chúng phải hỏi xin Token từ Redis. Nếu Redis báo cạn Token, worker bắt buộc phải sleep theo khoảng thời gian Redis tính toán trả về.
Tuân thủ robots.txt chuẩn RFC 9309
Tiêu chuẩn RFC 9309 do IETF ban hành quy định chuẩn mực ứng xử của bot web. Việc tuân thủ RFC 9309 chứng minh hệ thống của bạn là luồng dữ liệu minh bạch:
- Định danh minh bạch: Khai báo User-Agent kèm thông tin liên lạc (ví dụ:
MarketDataBot/1.0 (+mailto:[email protected])). - Nguyên tắc khớp dài nhất (Longest match): Khi một đường dẫn bị vướng cả lệnh
AllowvàDisallowtrong robots.txt, bot bắt buộc phải ưu tiên áp dụng quy tắc có chuỗi ký tự dài cụ thể hơn. - Chiến lược lưu đệm (Caching): Parser của crawler cần cache file
robots.txtcủa mỗi domain để giảm tải cho máy chủ đích, nhưng thời gian lưu (TTL) không nên vượt quá 24 giờ để đảm bảo cập nhật kịp thời các thay đổi chính sách từ website.
Xử lý HTTP 429: Cơ chế Circuit Breaker & Retry-After
Đây là điểm phân biệt giữa một Data Engineer chuyên nghiệp và một hệ thống thiếu tối ưu. Mã HTTP 429 không phải là lỗi kết nối mạng thông thường (như 500 hay timeout); nó là tín hiệu chủ động từ máy chủ yêu cầu bạn chậm lại. Tuyệt đối KHÔNG luân chuyển IP ngay lập tức khi gặp mã 429.
Lúc này, hệ thống cần kích hoạt Circuit Breaker (Ngắt mạch):
- Ngắt mạch (OPEN): Cấm toàn bộ worker gửi thêm request đến domain đó ngay lập tức.
- Đọc Header
Retry-After: Phân tích xem máy chủ yêu cầu chờ bao nhiêu giây. Nếu có, đặt thời gian ngắt mạch đúng bằng giá trị này. - Exponential Backoff & Full Jitter: Nếu máy chủ không cung cấp
Retry-After, áp dụng thuật toán lùi thời gian theo cấp số nhân kết hợp yếu tố ngẫu nhiên (Jitter). Tránh tình trạng hàng loạt worker cùng tỉnh dậy và gửi request tại đúng một thời điểm sau khi hết thời gian chờ. - Thăm dò (HALF-OPEN): Hết thời gian chờ, hệ thống chỉ cho phép một luồng duy nhất gửi request mồi (canary probe). Nếu nhận lại mã 200, mạch đóng lại (CLOSED) và băng thông được khôi phục.
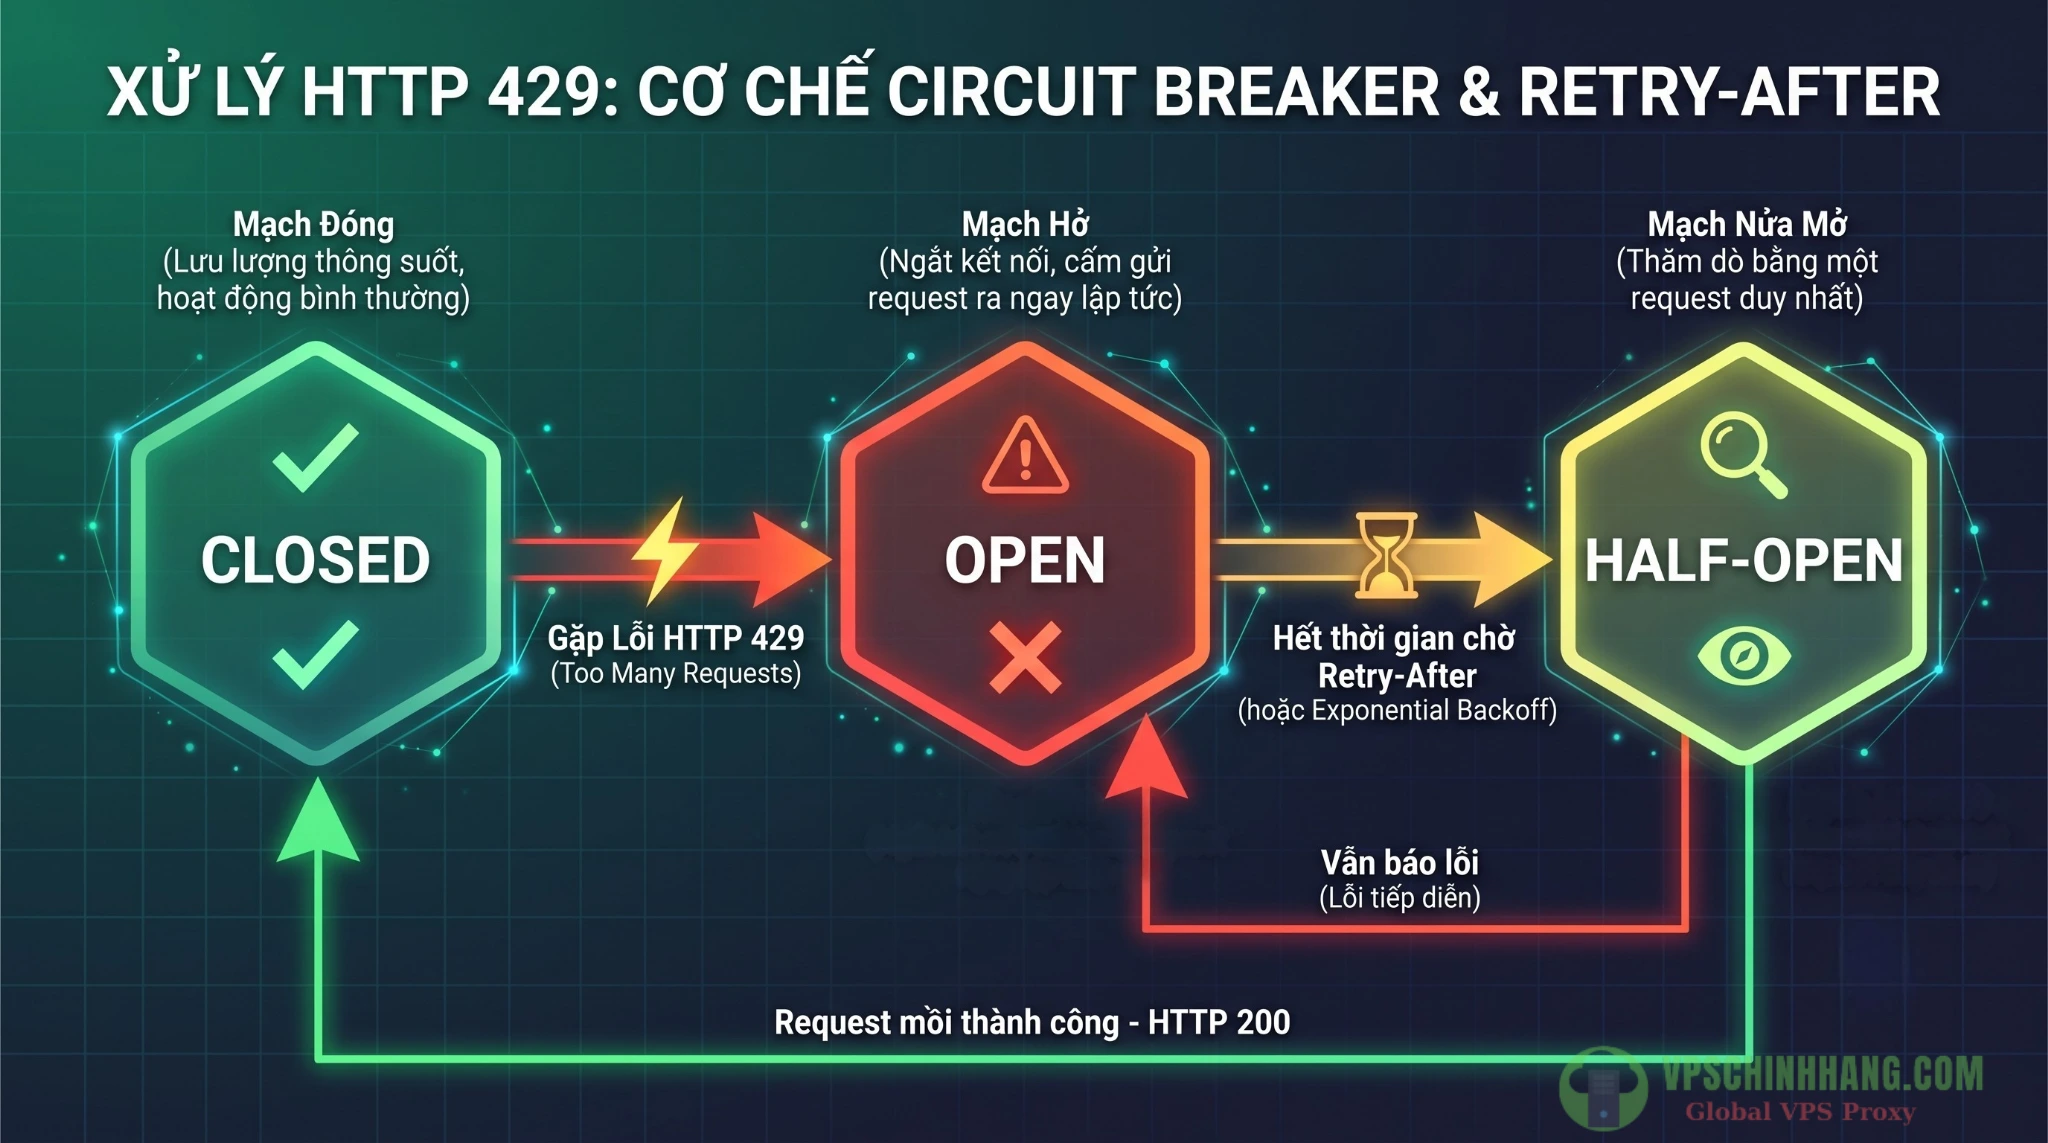
Vòng lặp trạng thái Circuit Breaker giúp bảo vệ hệ thống khỏi hiện tượng Retry Storm khi máy chủ đích báo quá tải.
Xu hướng mới: Dịch chuyển sang Rotating Proxy API & nền tảng tự động
Mặc dù việc tự cấu hình Squid và Redis mang lại sự kiểm soát tuyệt đối, nhưng kiến trúc này ngày càng bộc lộ nhược điểm cồng kềnh và tốn kém chi phí kỹ sư vận hành (DevOps). Hiện tại, xu hướng thiết lập Forward Proxy thu thập dữ liệu đang dịch chuyển mạnh mẽ sang các giải pháp Managed (quản lý sẵn):
- Rotating Proxy API Gateways: Thay vì tự quản lý danh sách IP, thực hiện health check và viết logic xoay vòng IP, developer chỉ cần trỏ request qua một endpoint duy nhất của nhà cung cấp Proxy (ví dụ:
gateway.provider.com:8000). Hệ thống backend của nhà cung cấp sẽ tự động xử lý lỗi failover, xoay IP và duy trì Sticky Session. Việc này giảm tải đáng kể khối lượng code hạ tầng. - Tích hợp nền tảng tự động hóa (Crawlee, Apify, Firecrawl): Thay vì tự build Global Rate Limiter, các framework hiện đại như Crawlee đã tích hợp sẵn tính năng
AutoscaledPool. Nó tự động đo lường độ trễ mạng, phản hồi 429 và tài nguyên RAM/CPU để linh hoạt tăng giảm số lượng luồng đồng thời mà không cần kỹ sư can thiệp thủ công. - Kiến trúc AI Self-Healing: Đối với các luồng dữ liệu e-commerce nơi giao diện HTML thay đổi liên tục, kiến trúc hiện đại đang dần áp dụng LLM (Large Language Models) để tự động sửa các hàm parse bị hỏng (self-healing), biến các pipeline dữ liệu trở nên ổn định và bền bỉ.
Giám sát sức khỏe Proxy & observability toàn hệ thống
Dù sử dụng hạ tầng tự host hay Managed API, hệ thống giám sát (Observability) là bắt buộc. Bạn không thể vận hành một cỗ máy xử lý hàng triệu request mà không có Dashboard rõ ràng. Developer có thể ứng dụng kỹ thuật giám sát băng thông VPS bằng Prometheus & Grafana để theo dõi sát sao tình trạng nghẽn cổ chai của các proxy node theo thời gian thực.
Các chỉ số (metrics) cốt lõi cần theo dõi:
- Success rate theo domain: Tỷ lệ mã HTTP 2xx so với mã 4xx/5xx.
- Cảnh báo HTTP 429 / 403 spike: Thiết lập webhook báo động qua Slack/Telegram ngay khi tỷ lệ lỗi 429 vượt ngưỡng 2% trong khung thời gian 15 phút.
- Độ trễ bách phân vị (p95 latency): Phản ánh tốc độ phản hồi thực tế của các proxy node. Giúp phát hiện sớm các node bị suy thoái băng thông.
Lưu ý bảo mật log: Mặc dù Squid hoặc Proxy Gateway ghi nhận access log rất hữu ích cho việc debug, kỹ sư cần cấu hình lọc bỏ các tham số nhạy cảm (session cookie, query string chứa token xác thực) trước khi lưu trữ vào hệ thống như ELK Stack để tuân thủ các chính sách bảo mật nội bộ.
Câu hỏi thường gặp (FAQ)
1. Tại sao tôi đã thiết lập thời gian nghỉ (delay) nhưng vẫn bị dính mã lỗi 429?
Vì delay chỉ làm chậm từng tiến trình (worker) độc lập. Nếu bạn chạy song song 50 worker, tổng số kết nối mở đồng thời (concurrency) đẩy lên máy chủ đích vẫn vượt trần giới hạn. Khắc phục bằng cách dùng Rate Limiter tập trung (ví dụ: Token Bucket trên Redis) để khống chế tổng request/giây của toàn cụm.
2. Có nên cấu hình tự động đổi IP ngay khi gặp lỗi HTTP 429 hoặc 403 không?
Tuyệt đối không. Hành vi này vi phạm nguyên tắc phân tán tải và quản lý kết nối an toàn. Hệ thống WAF hiện đại sẽ nhanh chóng phát hiện sự bất thường và chặn toàn bộ dải mạng của bạn. Hãy thiết lập Circuit Breaker để ngắt luồng và chờ theo thời gian của header Retry-After.
3. Nên luân chuyển IP (Rotate) theo từng request hay giữ cố định theo phiên (Sticky Session)?
Điều này phụ thuộc vào target:
- Per-request: Áp dụng khi thu thập dữ liệu tĩnh, không cần trạng thái (như quét giá, danh mục sản phẩm).
- Sticky Session (Cố định IP 15-30 phút): Áp dụng khi luồng dữ liệu cần duy trì cookie, đi qua giỏ hàng hoặc thực hiện các bước điền form liên tiếp.
4. Tuân thủ robots.txt là bắt buộc hay chỉ mang tính khuyến nghị?
Theo tiêu chuẩn RFC 9309, robots.txt không phải là một lớp bảo mật vật lý chặn bạn kết nối, nhưng nó là bộ quy tắc ứng xử mà các bot minh bạch bắt buộc phải tuân thủ. Việc tôn trọng file này chứng minh hệ thống của bạn hoạt động hợp lệ và tránh rủi ro pháp lý về sau.
5. Làm sao để Squid Proxy không bị lợi dụng thành mạng botnet (Open Proxy)?
Chỉ cấu hình (bind) cổng lắng nghe của Squid vào IP nội bộ (qua VPC hoặc VPN WireGuard), không bao giờ mở trên 0.0.0.0. Đồng thời, thiết lập Access Control Lists (ACLs) khóa chặt IP nguồn và luôn kết thúc bằng quy tắc http_access deny all ở cuối file cấu hình.
Kết luận
Một hệ thống thu thập dữ liệu thương mại điện tử chuyên nghiệp không đo lường sức mạnh ở việc sở hữu bao nhiêu nghìn IP, mà nằm ở tính kỷ luật của kiến trúc mạng: định danh minh bạch, điều phối tốc độ tập trung và phản ứng chuẩn xác khi website đích báo hiệu quá tải.
Trước khi nhấn nút triển khai (deploy) kiến trúc Forward Proxy lên môi trường Production, hãy cùng rà soát lại checklist 5 bước sau:
- [ ] Worker đã cấu hình User-Agent mang tính định danh rõ ràng, đính kèm email/website của team Data chưa?
- [ ] Logic parse
robots.txtđã hoạt động đúng chuẩn RFC 9309 và có chính sách cache hợp lý chưa? - [ ] Nếu tự quản trị Squid, cổng Proxy đã được khóa chặt bằng ACL và Firewall (chỉ cho phép traffic từ VPC nội bộ) chưa?
- [ ] Token Bucket (Rate Limiter tập trung) đã hoạt động trơn tru, dàn đều request từ nhiều worker khác nhau chưa?
- [ ] Cơ chế Circuit Breaker có chủ động ngắt toàn cụm và tuân thủ chặt chẽ header
Retry-Afterkhi dính lỗi 429 không?
Việc nắm vững các kỹ thuật điều phối lưu lượng này chính là nền tảng cốt lõi để xây dựng hệ thống thu thập dữ liệu thị trường với VPS và Proxy minh bạch, hợp pháp.
Lưu ý quan trọng: Bài viết tập trung vào các giải pháp kỹ thuật hạ tầng. Khi thực hiện thu thập dữ liệu, developer cần phối hợp với bộ phận pháp chế để đảm bảo tuân thủ điều khoản sử dụng (ToS) của nền tảng đích và tuyệt đối không thu thập dữ liệu định danh cá nhân (PII).
Tài liệu tham khảo
- RFC 9309: Robots Exclusion Protocol | RFC Editor
- squid : Optimising Web Delivery
- 429 Too Many Requests – HTTP | MDN
- Scalable AI-Driven Web Data Extraction Systems: Design and Implementation of an Enterprise Market Analytics Scraping Assistant | Chandrashekar | International Journal of Engineering, Science and Information Technology
- Squid Proxy vs HAProxy: Comprehensive Comparison for Cloud & DevOps | by Harikrishnan M | DevOps.dev
Hướng dẫn tối ưu bộ nhớ Rust 1.100 Cloud Server: Dùng Allocator API cắt đứt nỗi lo OOM
Hướng dẫn chi tiết vá lỗi CVE-2026-48842 Webmail Server: Ngăn chặn SQL Injection chiếm quyền Database